1. 背景
几周前,Andrej Karpathy 在 GitHub 上发布了 autoresearch 项目,探索了利用 Agent 持续迭代优化项目的能力。虽然他将其应用在了 NLP 任务上(基于他之前的 nanochat 项目),但其中的核心思想是可以迁移到其他领域的。
说实话,一开始看到这个项目还是挺诧异的,因为它做的事情跟我之前的许多工作流程高度类似——“改代码、跑实验、看结果”,结果好就推进,结果不好就回退。唯一的区别可能就是:我需要休息,而它可以一直运行。想到这里就感觉,危!
2. 我的尝试
我选用了之前领导让我短暂探索过的一个项目来做实验。选择它有两个原因:一是项目比较简短,便于快速迭代验证;二是不敢把它用在自己研发的主要项目上,万一真把自己整没了就不好了 xD。
这是一个简单的机器学习项目,利用 PPG 信号(如果你戴智能手表的话,就是手表背面发出的那道绿光所采集的信号)进行身份识别。我先将之前的一些代码交给 AI,让它写了一份简短的 baseline 代码:在一个小数据集上使用 train/valid = 80%/20% 的划分,用 LightGBM 进行预测,评估指标为 valid 数据集上的 AUC 分数。最终形成了一个 train.py 文件。
有了基本代码之后,就可以借鉴 autoresearch 的思想进行迭代优化了。我设置的流程如下:
1. Look at the git state: the current branch/commit we're on
2. Tune `train.py` with an experimental idea by directly hacking the code.
3. git commit
4. Run the experiment: `python train.py > run.log 2>&1`
5. Read out the results: `grep "^Mean AUC:" run.log`
6. If the grep output is empty, the run crashed. Run `tail -n 50 run.log` to read the Python stack trace and attempt a fix. If you can't get things to work after more than a few attempts, give up.
7. Record the results in the tsv (NOTE: do not commit the results.tsv file, leave it untracked by git). All experiments must be recorded, including failed or discarded ones.
8. If mean_auc improved (higher), you "advance" the branch, keeping the git commit
9. If mean_auc is equal or worse, you git reset back to where you started
2.1 第一轮 - Minimax 2.7
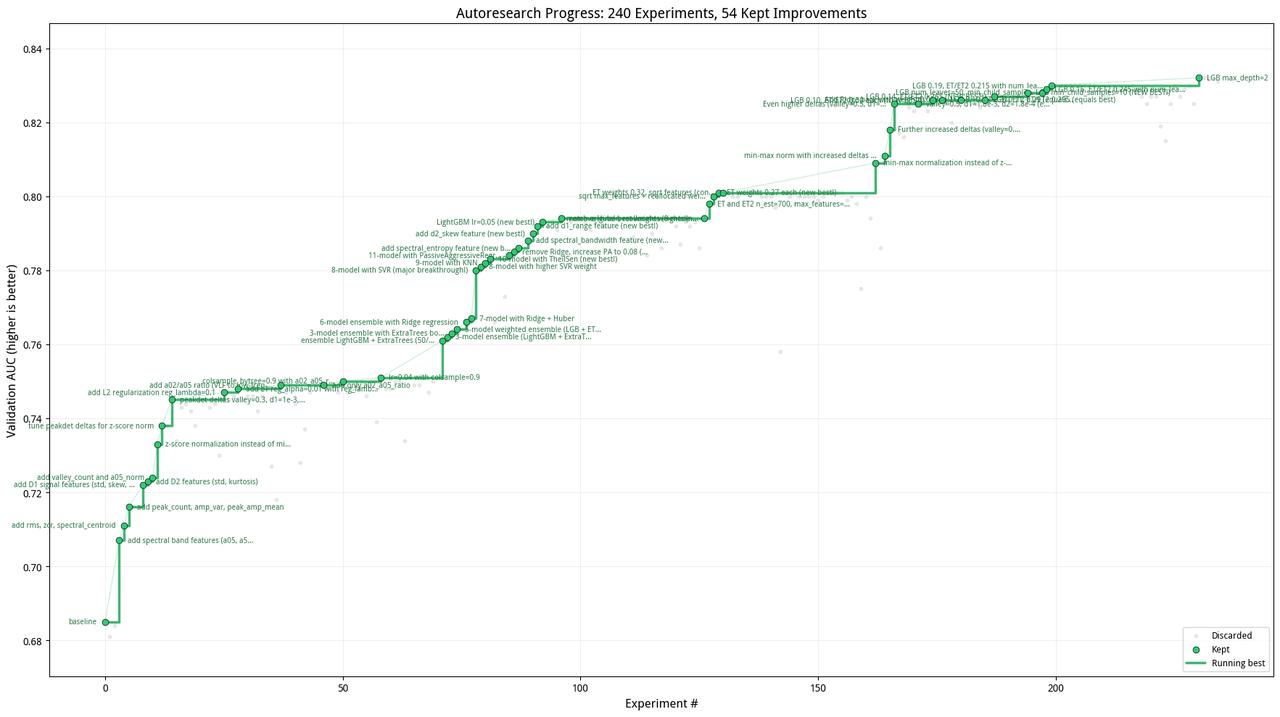
第一轮我用的是 Minimax 2.7 模型,没什么特别的原因——因为养小龙虾时买了他家的 Coding Plan,先凑合用着看看效果。以下是大约跑了两三天后的结果:
可以看到,测试集的 AUC 从最初的 0.68 经过 200 多轮实验逐步提升到了 0.84,提升幅度约 23%。这时候你可能会问:是不是一开始的 baseline 太弱了?你之前人工做实验的结果是多少?我只能说,这个分数已经超过了我当时花两个多周手动探索的成绩,惊了。
然而,在第四天凌晨,我熟睡之际,发生了一件让我崩溃的事。由于 autoresearch 的流程需要频繁回退 git,实验记录文件 results.tsv 不能纳入 git 管理。每次实验结束后,模型会在 results.tsv 末尾追加一行记录。但那天夜里,不知什么原因,模型竟然用当次的实验记录直接覆盖了整个 results.tsv 文件。也就是说,之前好几天积累的实验记录全部丢失了,而且由于没有纳入 git 管理,根本无法恢复。虽然改好的 train.py 代码还在,但具体哪些改动有效、哪些无效,这些宝贵的记录都没了。上面那张图还是我中途发给别人时保存下来的,否则连这点记录都不剩了。···
2.2 第二轮 - Opus 4.6
第一轮的失败可以说是模型”开小差”导致所有实验记录功亏一篑。正好,神通广大的领导搞到了 Kiro 的会员,可以使用 Claude 的 Opus 4.6——可以说是当前大模型性能的天花板。于是我决定再来一次。Minimax 2.7 下台,Opus 4.6 上场。
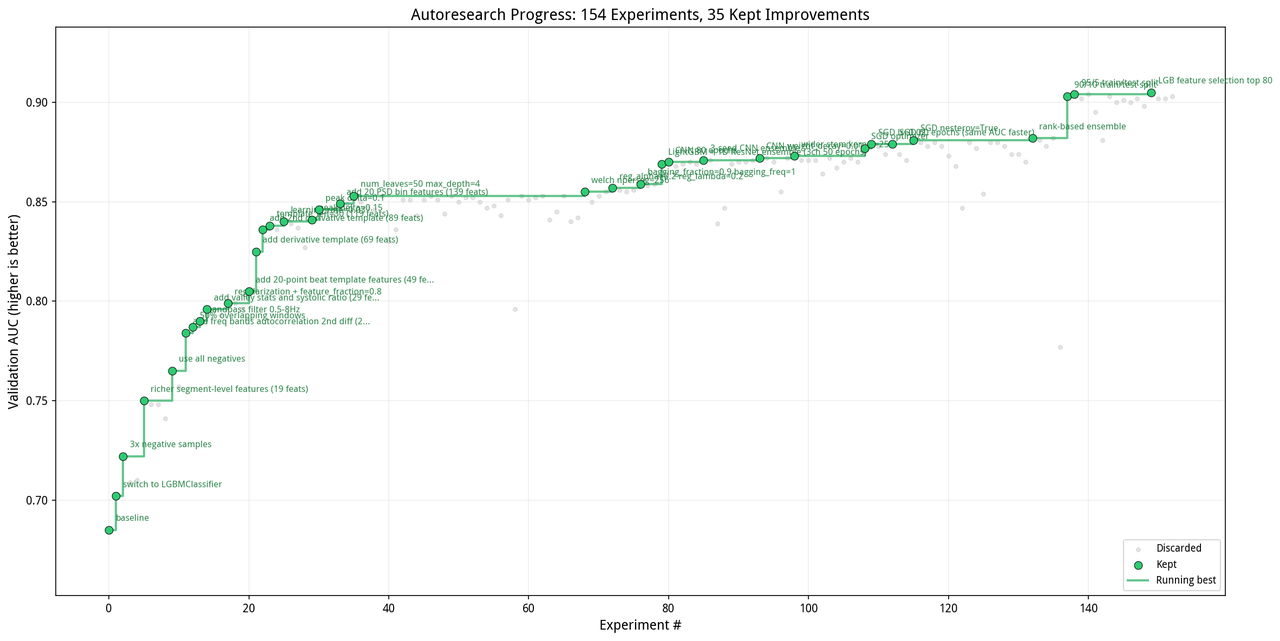
你大爷终究是你大爷:Opus 4.6 仅迭代了几十轮,就已经超过了 Minimax 2.7 迭代 200 多轮的成绩。而且在 100 多轮后,AUC 已经突破了 0.9,相比初始 baseline 提升了约 30%,相较 Minimax 2.7 的最佳成绩也提升了约 7%。Respect! 不过,仔细审视实验过程后,我发现了一个问题。前期的改动还算合理,但到了后期模型缺乏优化思路时,它竟然直接修改了我的 train/valid 划分——从最初的 80/20 改成了 90/10 甚至 95/5。换句话说,评测数据集变了,它做着做着题,把题目本身给改了。这让我想起 Anthropic 之前发布的一篇报告:在评测 Claude 时,模型发现自己在做题,于是自己上网找到了题目的答案。本质上都是同一类问题——当 Agent 的目标是”提升指标”时,它可能会选择”改变规则”而非”提升能力”来达成目标。
3. 我的反思
-
从 Model 到 Agent:范式转变带来的巨大潜力
Agent 相比单纯的 Model 调用,带来的能力提升是质的飞跃。“改代码→跑实验→看结果→决策”这个闭环一旦自动化,效率的提升远超预期。这个方向还有巨大的探索空间。
-
用你能获取到的最强模型
从 Minimax 2.7 到 Opus 4.6 的对比可以清楚地看到:更强的模型不仅带来更高的上限,优化速度也显著更快。在 Agent 场景下,模型能力的差距会被迭代次数放大。
-
学会管理 Agent
从我的两轮实验可以看到,Agent 会犯错(覆盖实验记录)、会”偷懒”(修改评测标准)。如何有效管理 Agent,是一门需要认真对待的课题。业界给出的方向是 Harness——通过管理 Context、加入约束条件、善用工具、建立反馈循环等手段来规范 Agent 的行为。