这篇文章从 Transformer 原理到 API 计费,再到 Claude Code 的缓存设计拆一遍。看完你会知道大模型账单里的钱花在哪、为什么缓存能省 80%,以及调用习惯怎么影响账单。
导读
本文比较长,按兴趣挑着看:
- 第一~三章:原理篇 — 缓存到底在缓存什么?(所有人)
- 第四章:API 层缓存 — 账单上的钱怎么省的?(开发者)
- 第五章:Claude Code 缓存工程 — 结合官方分享和使用观察做拆解(CC 用户 / 开发者)
- 第六章:缓存杀手 — 哪些操作在悄悄烧钱?(CC 用户)
- 第七章 + 总结:最佳实践 — 没时间的直接看这里(所有人)
一、背景
下面是我上个月的 Mify 账单:
第一次看到这个账单的人通常会懵:缓存写入是什么?为什么有 5 分钟和 1 小时两种?缓存命中的费用为什么这么低/高?
这篇文章就是要把这几个数字背后的机制讲清楚。
核心结论先放这里:同样的调用量,理解缓存机制的人比不理解的人,API 费用差 3~5 倍。
二、没有缓存的世界
大模型没有记忆。
每一轮对话,你都要把完整的历史消息重新发给模型,它才知道之前聊了什么。就像一个失忆的专家,每次见面都要从头自我介绍。
第 1 轮:[系统提示] + [你的问题1]
第 2 轮:[系统提示] + [你的问题1] + [AI回复1] + [你的问题2]
第 3 轮:[系统提示] + [你的问题1] + [AI回复1] + [你的问题2] + [AI回复2] + [你的问题3]
...
每一轮的输入都在膨胀:
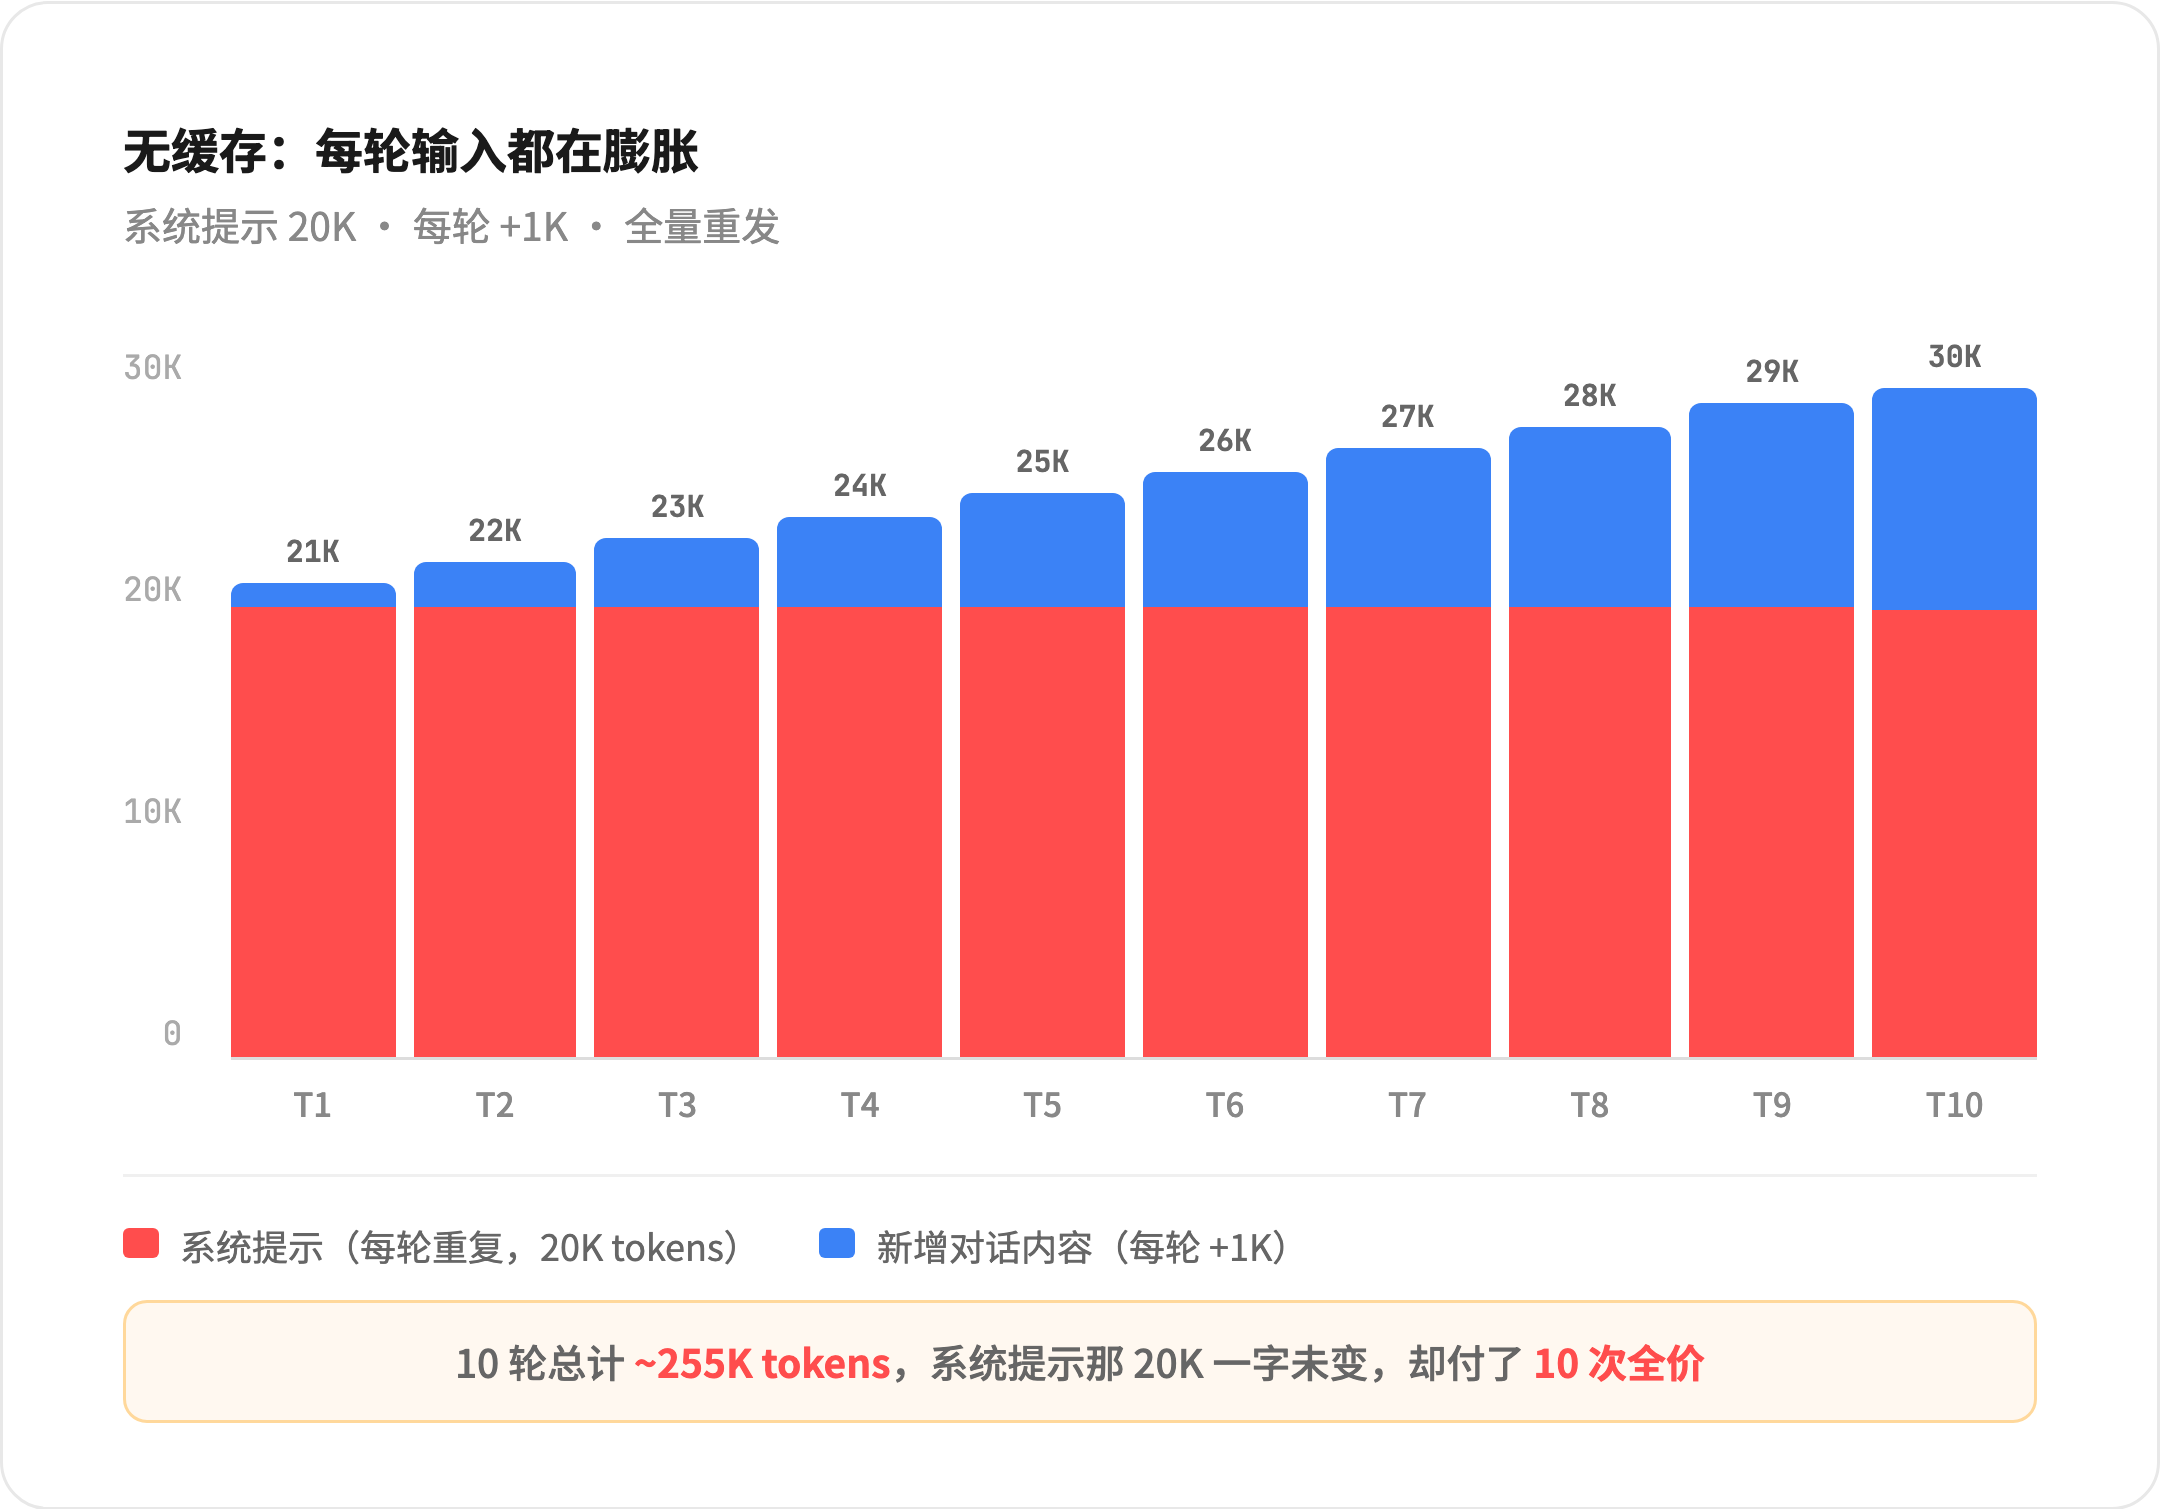
假设:系统提示 20K tokens,每轮对话增加 ~1K tokens

  Turn 1:  20K + 1K = 21K tokens      全价
  Turn 2:  20K + 2K = 22K tokens      全价
  Turn 3:  20K + 3K = 23K tokens      全价
  ...
  Turn 10: 20K + 10K = 30K tokens     全价
  ────────────────────────────
  10 轮总计:~255K tokens(全价)       ← 二次增长,越聊越贵
10 轮对话,你为系统提示付了 10 次全价。那 20K tokens 的内容一个字都没变,每次都要重新”读”一遍。
没有缓存,你在为重复的内容反复付费。
三、KV Cache:大模型的”记忆芯片”
3.1 先看实验数据
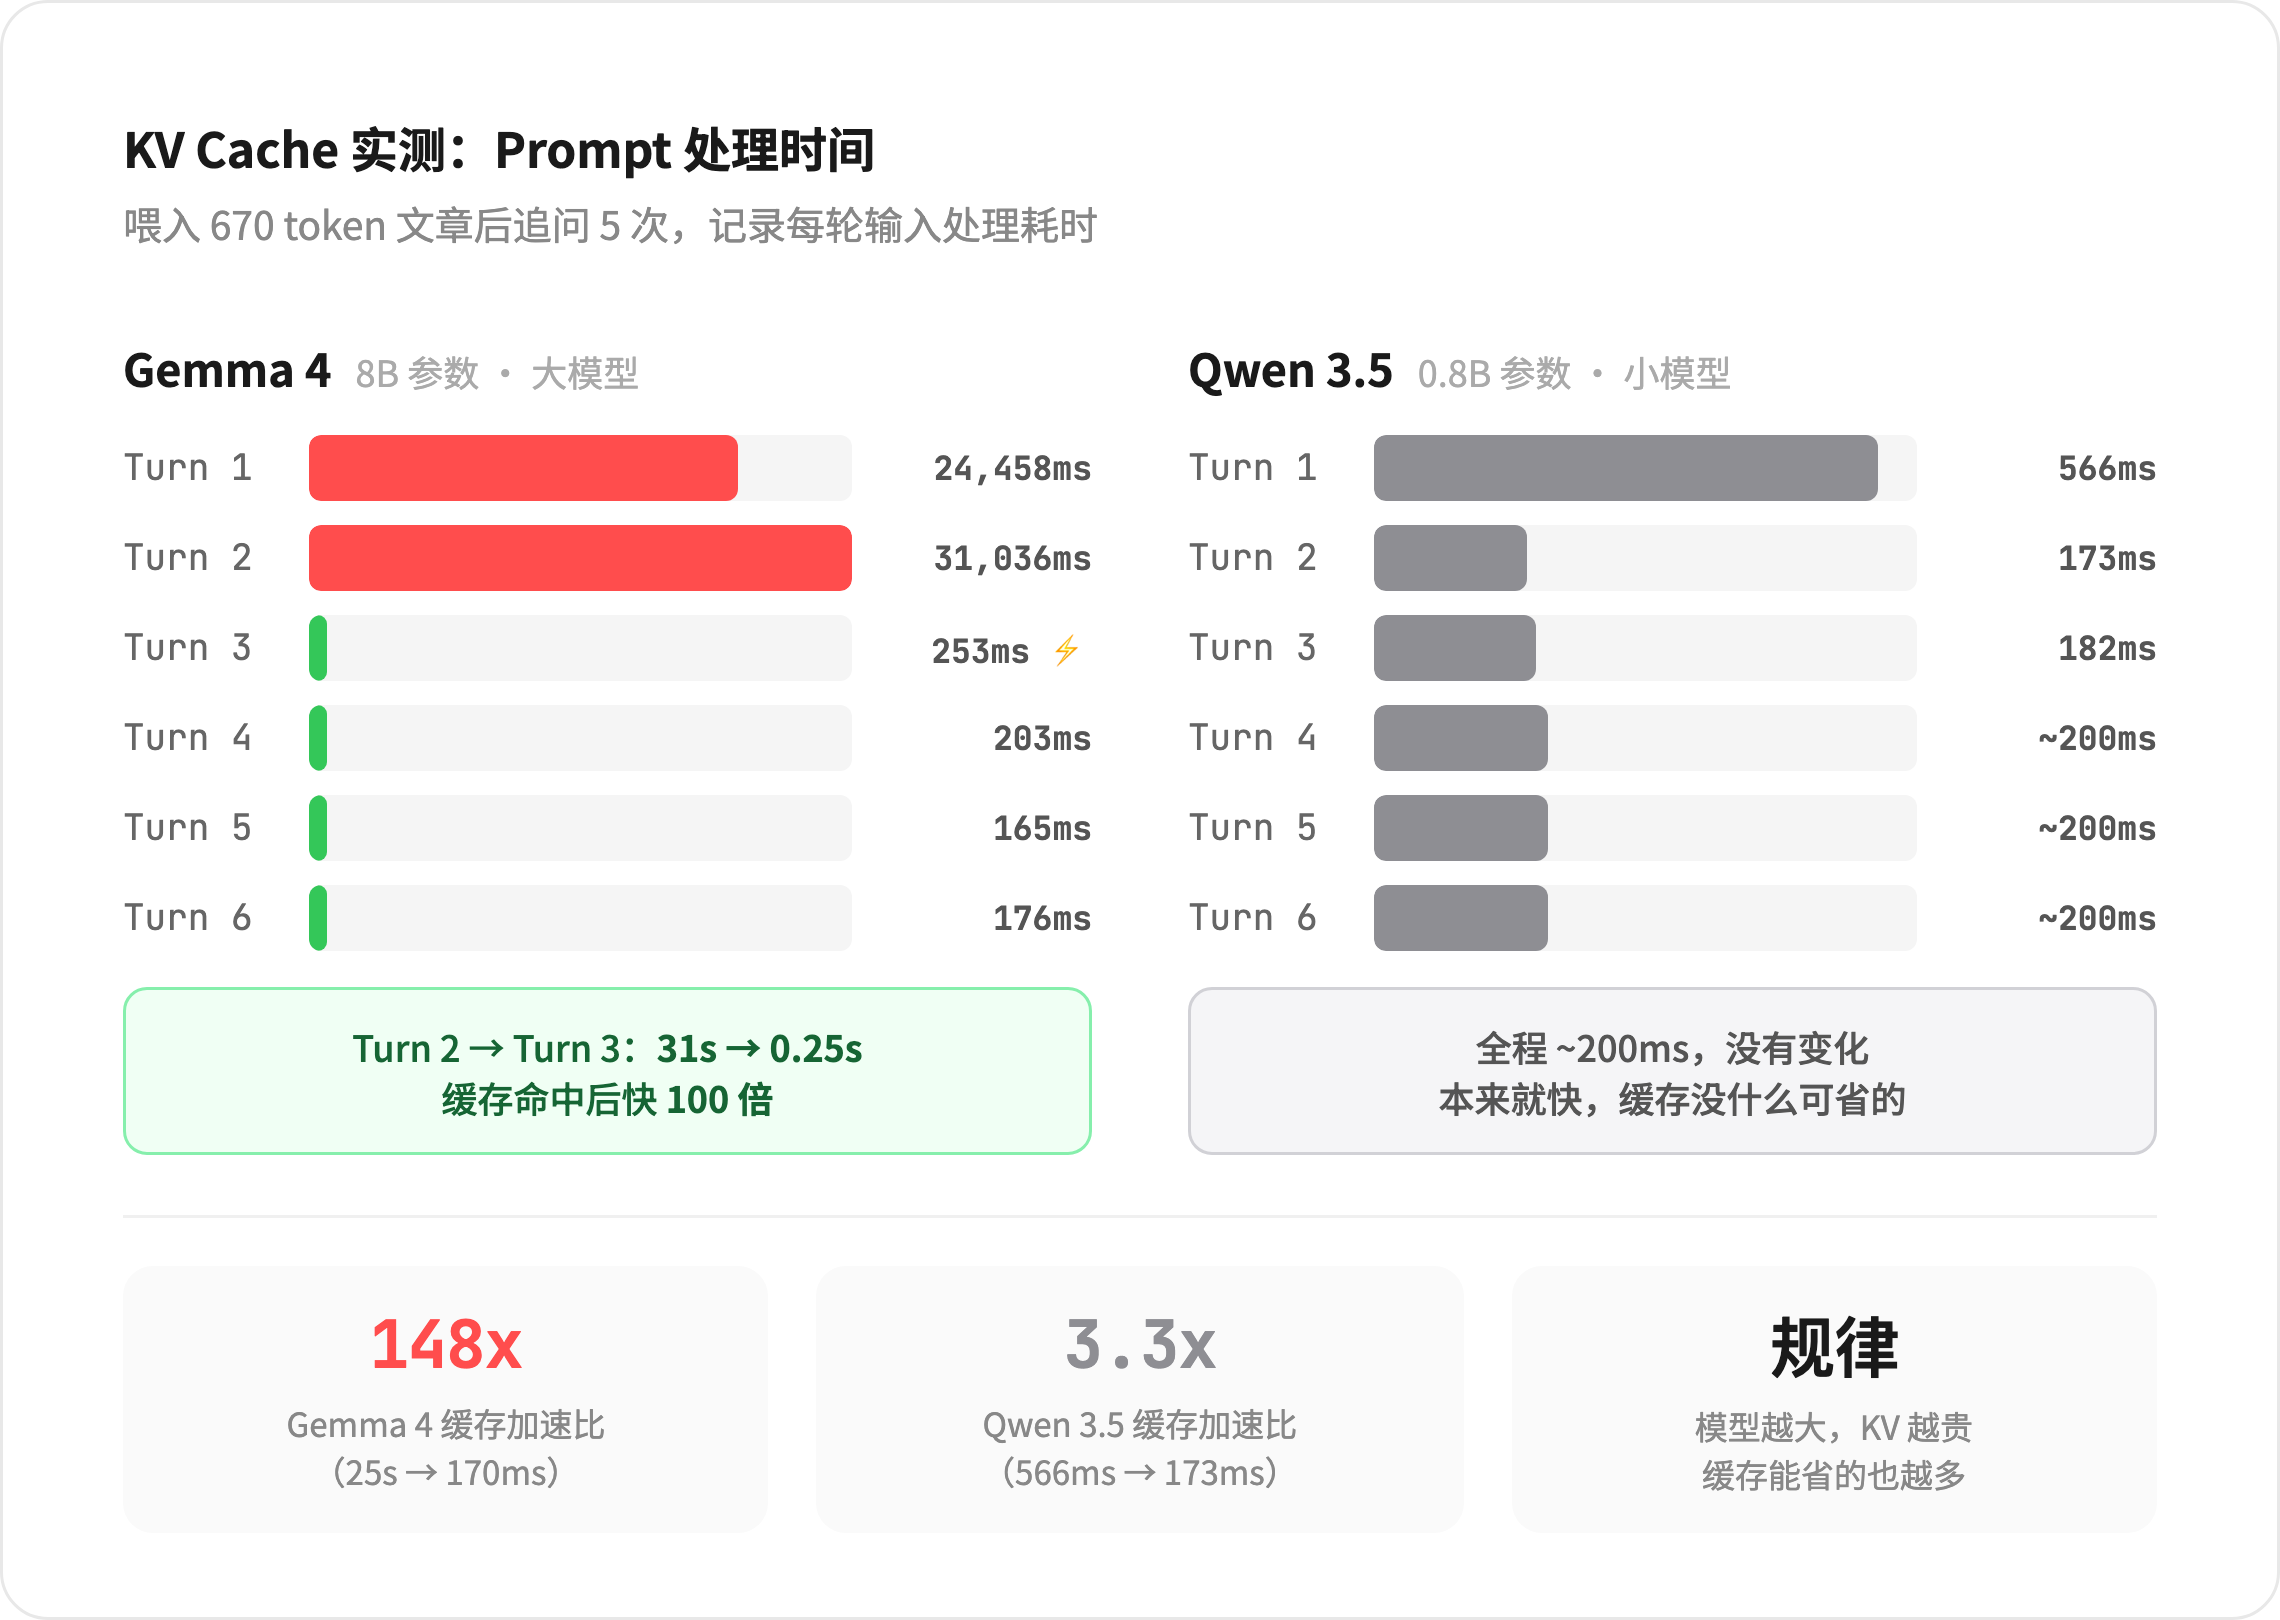
有人在本地用一个 8B 级别模型跑了一个多轮对话测试:先喂一篇 670 token 的文章,然后连续追问 5 个问题。
                 Prompt 处理时间    生成时间
Turn 1 (喂文章):   24,458ms         5,095ms
Turn 2 (追问1):    31,036ms        22,653ms
Turn 3 (追问2):       253ms  ←!!    2,511ms
Turn 4 (追问3):       203ms         2,029ms
Turn 5 (追问4):       165ms         1,870ms
Turn 6 (追问5):       176ms         1,235ms
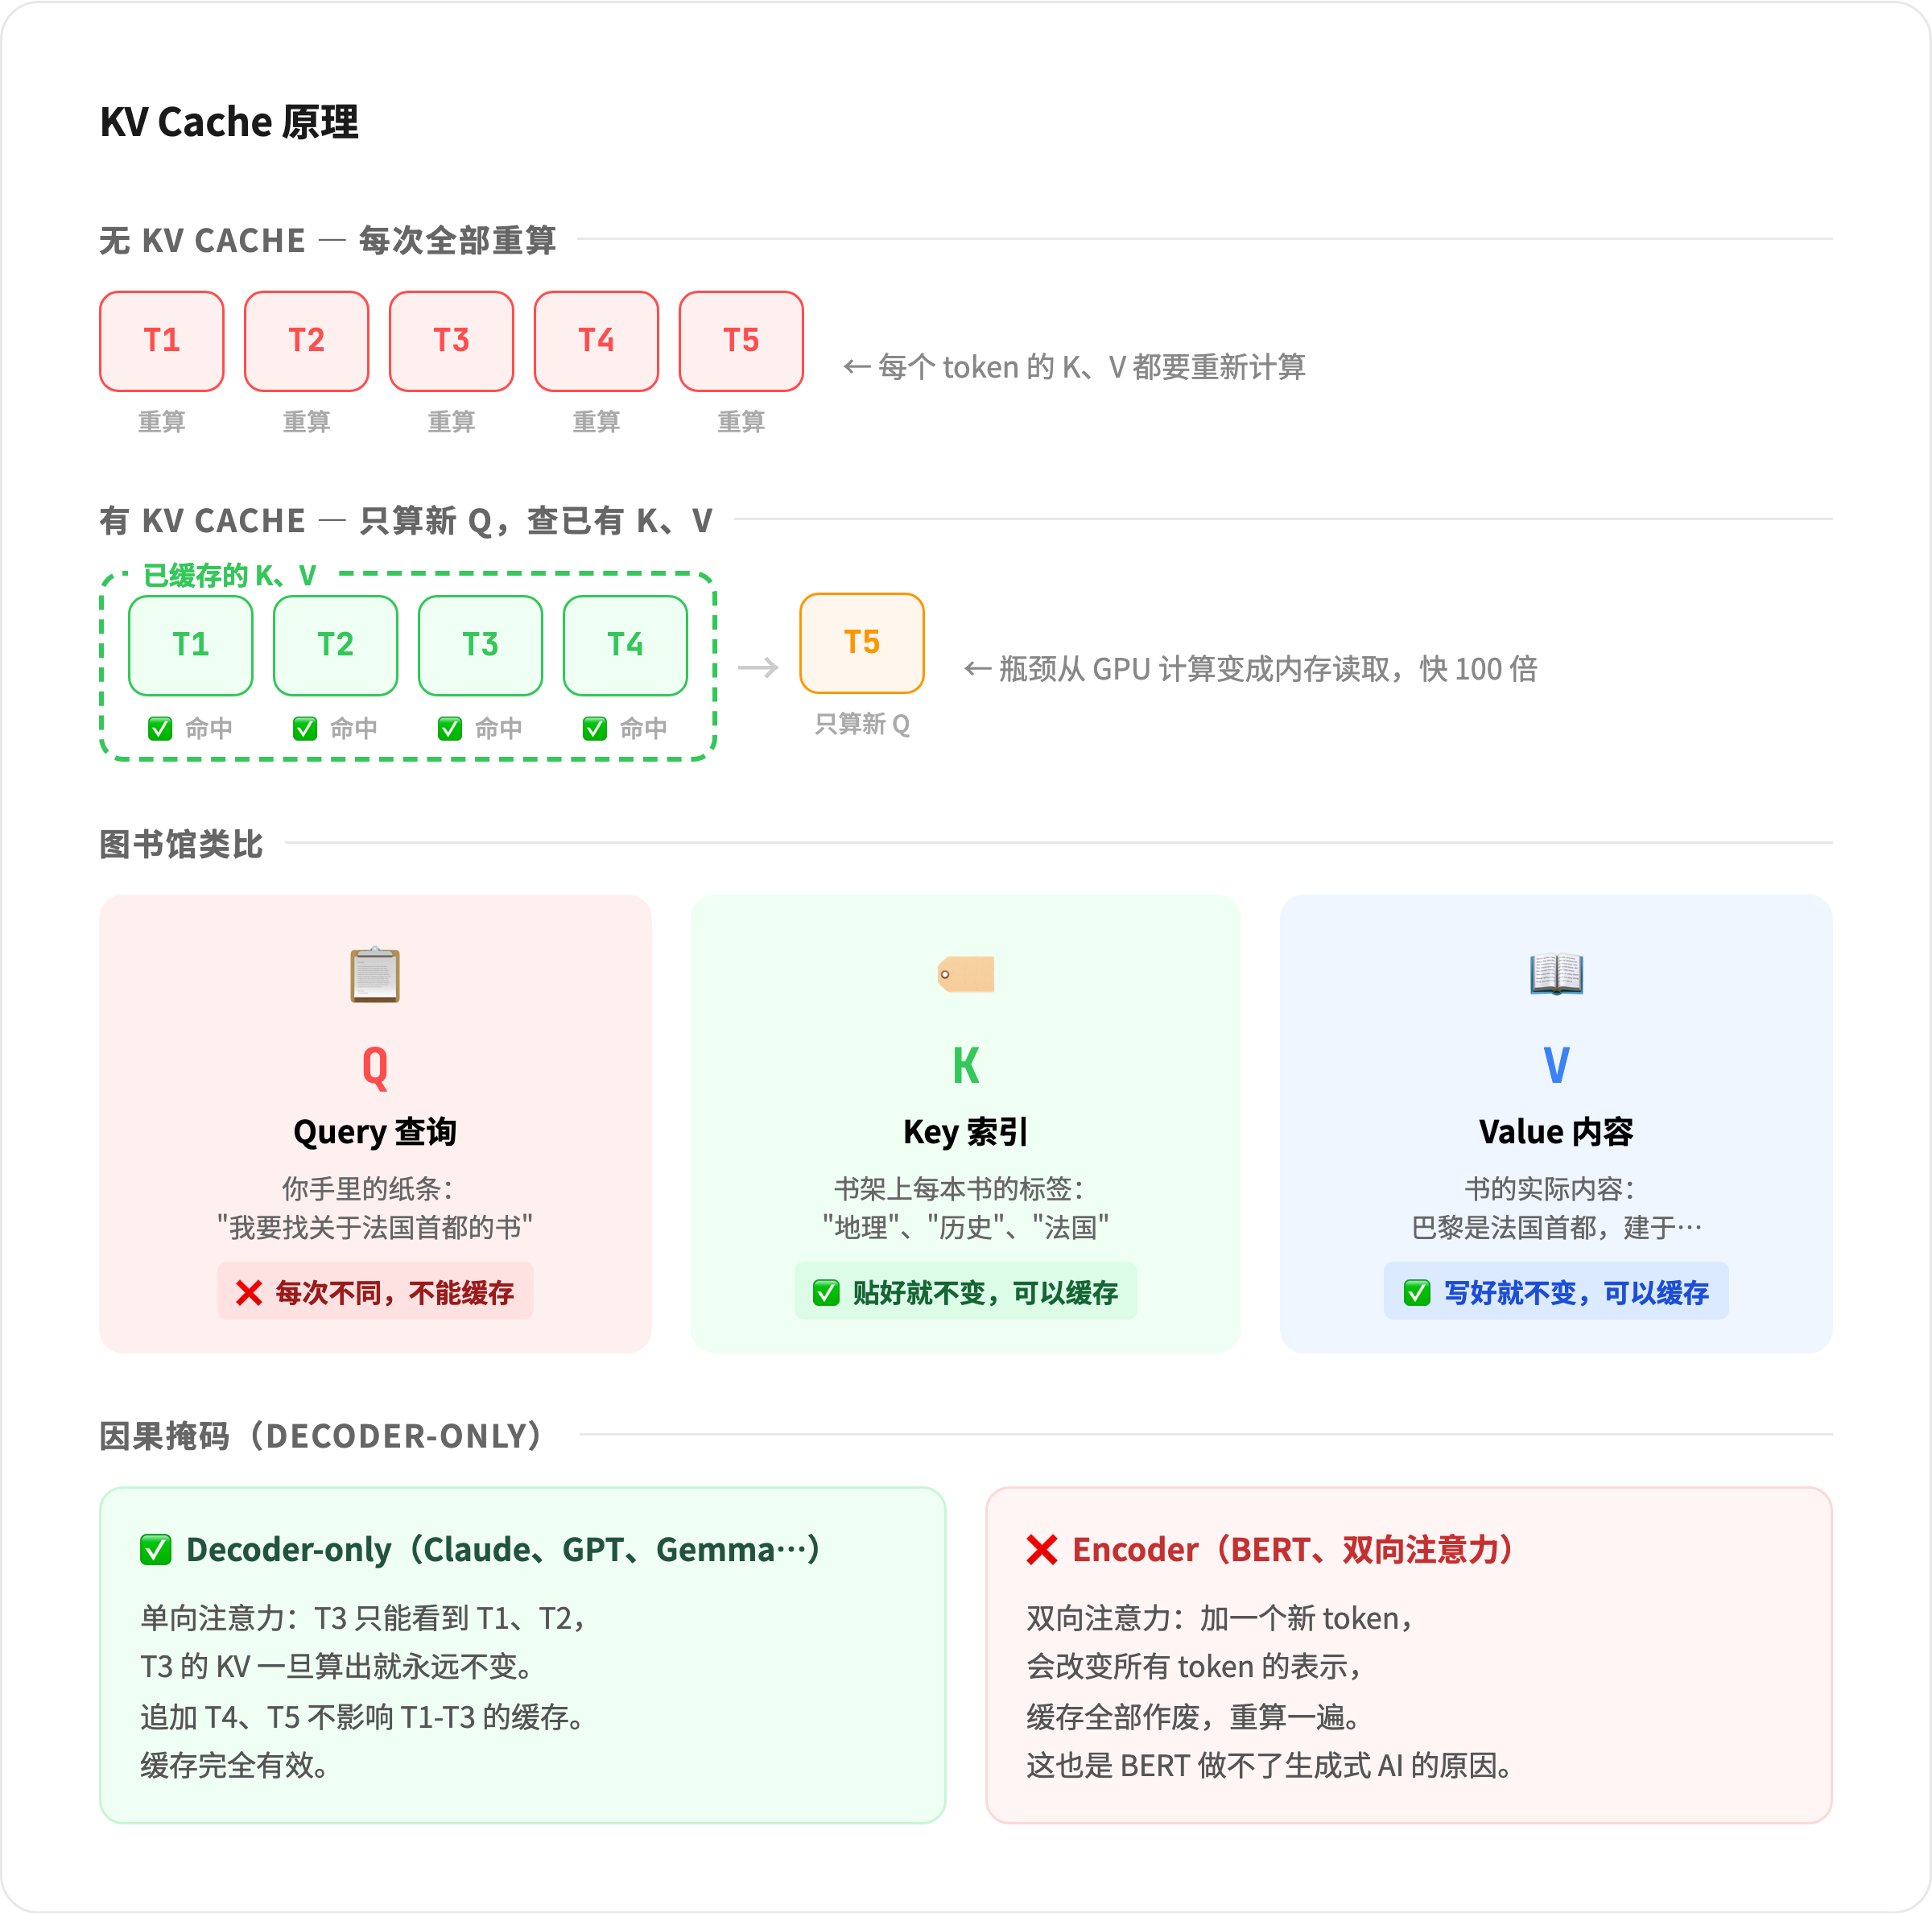
Turn 2 到 Turn 3,输入处理时间从 31 秒直降到 0.25 秒。100 倍。生成速度全程稳定在 13-20 tok/s,没有变化——加速只发生在”消化输入”阶段。
再看一个 0.8B 级别小模型的对比:
                 Prompt 处理时间
Turn 1 (喂文章):   566ms
Turn 2 (追问1):    173ms
Turn 3 (追问2):    182ms
Turn 4-6:          200ms 上下,波澜不惊
小模型全程 200ms,平得很。
两个问题:那个 100x 加速是什么?为什么大模型受益巨大,小模型却无感?
3.2 答案:注意力机制里的 KV
大模型用的是 Transformer 注意力机制。核心公式:
Attention(Q, K, V) = softmax(Q · Kᵀ / √d) · V用图书馆类比:
- Q (Query) — 你手里的纸条:“我要找关于法国首都的书”。每次不同,不能缓存
- K (Key) — 书架上每本书的标签:“地理”、“历史”、“法国”。贴好就不变,可以缓存
- V (Value) — 书的实际内容。写好就不变,可以缓存
KV Cache 就是把标签(K)和内容(V)存起来。下次来人,只需要看他的纸条(Q),直接查,不用重新贴标签。
3.3 为什么这行得通?因果掩码
这之所以可行,是因为用于文本生成的主流大模型通常按 自回归 方式工作:生成下一个 token 时,只依赖前面的 token。
因果掩码(causal mask):
        T₁   T₂   T₃   T₄
  T₁    ✅    ❌    ❌    ❌
  T₂    ✅    ✅    ❌    ❌
  T₃    ✅    ✅    ✅    ❌    ← T₃ 的 KV 永远不变
  T₄    ✅    ✅    ✅    ✅    ← 新增 T₄ 不影响 T₁₂₃
前面 token 的 KV 算完就固定了,后面怎么追加都不影响。你在第 100 页写了新内容,前 99 页不会因此改变。
BERT 这类 encoder-only 模型用的是双向注意力,加一个新 token 会改变已有 token 的表示,无法像自回归生成模型这样直接复用整段前缀的 KV。这也是 BERT 更适合做理解类任务,而不是直接做逐 token 生成的原因。
3.4 回到实验数据
- Turn 1 慢(24 秒):首次请求,模型要为 670 个 token 逐层计算 KV 张量(60 层 × 670 token × 2(K+V)),没有任何缓存可用
- Turn 2 也慢(31 秒):这轮没有稳定命中上一轮的 KV,可能和会话重建、上下文变长或运行时缓存淘汰有关。加上 Turn 2 的输入更长,反而比 Turn 1 还慢
- Turn 3 突然快(0.25 秒):缓存稳定命中,之前算好的 KV 全部在内存里,瓶颈从 GPU 计算变成了内存读取
- Turn 4-6 持续快:每轮只需要为新增的几十个 token 计算 KV
- 小模型无感:0.8B 级别模型算 KV 本来就只要 200ms,缓存省不了多少
模型越大,KV 计算越贵,缓存收益越大。
                    8B 级别模型              0.8B 级别模型
未命中               ~25,000ms               ~566ms
命中                 ~170ms                  ~173ms
加速比               148x                    3.3x
命中时两个模型速度几乎一样——都是从内存读取,计算量可以忽略。
四、Prompt Cache:API 层的缓存
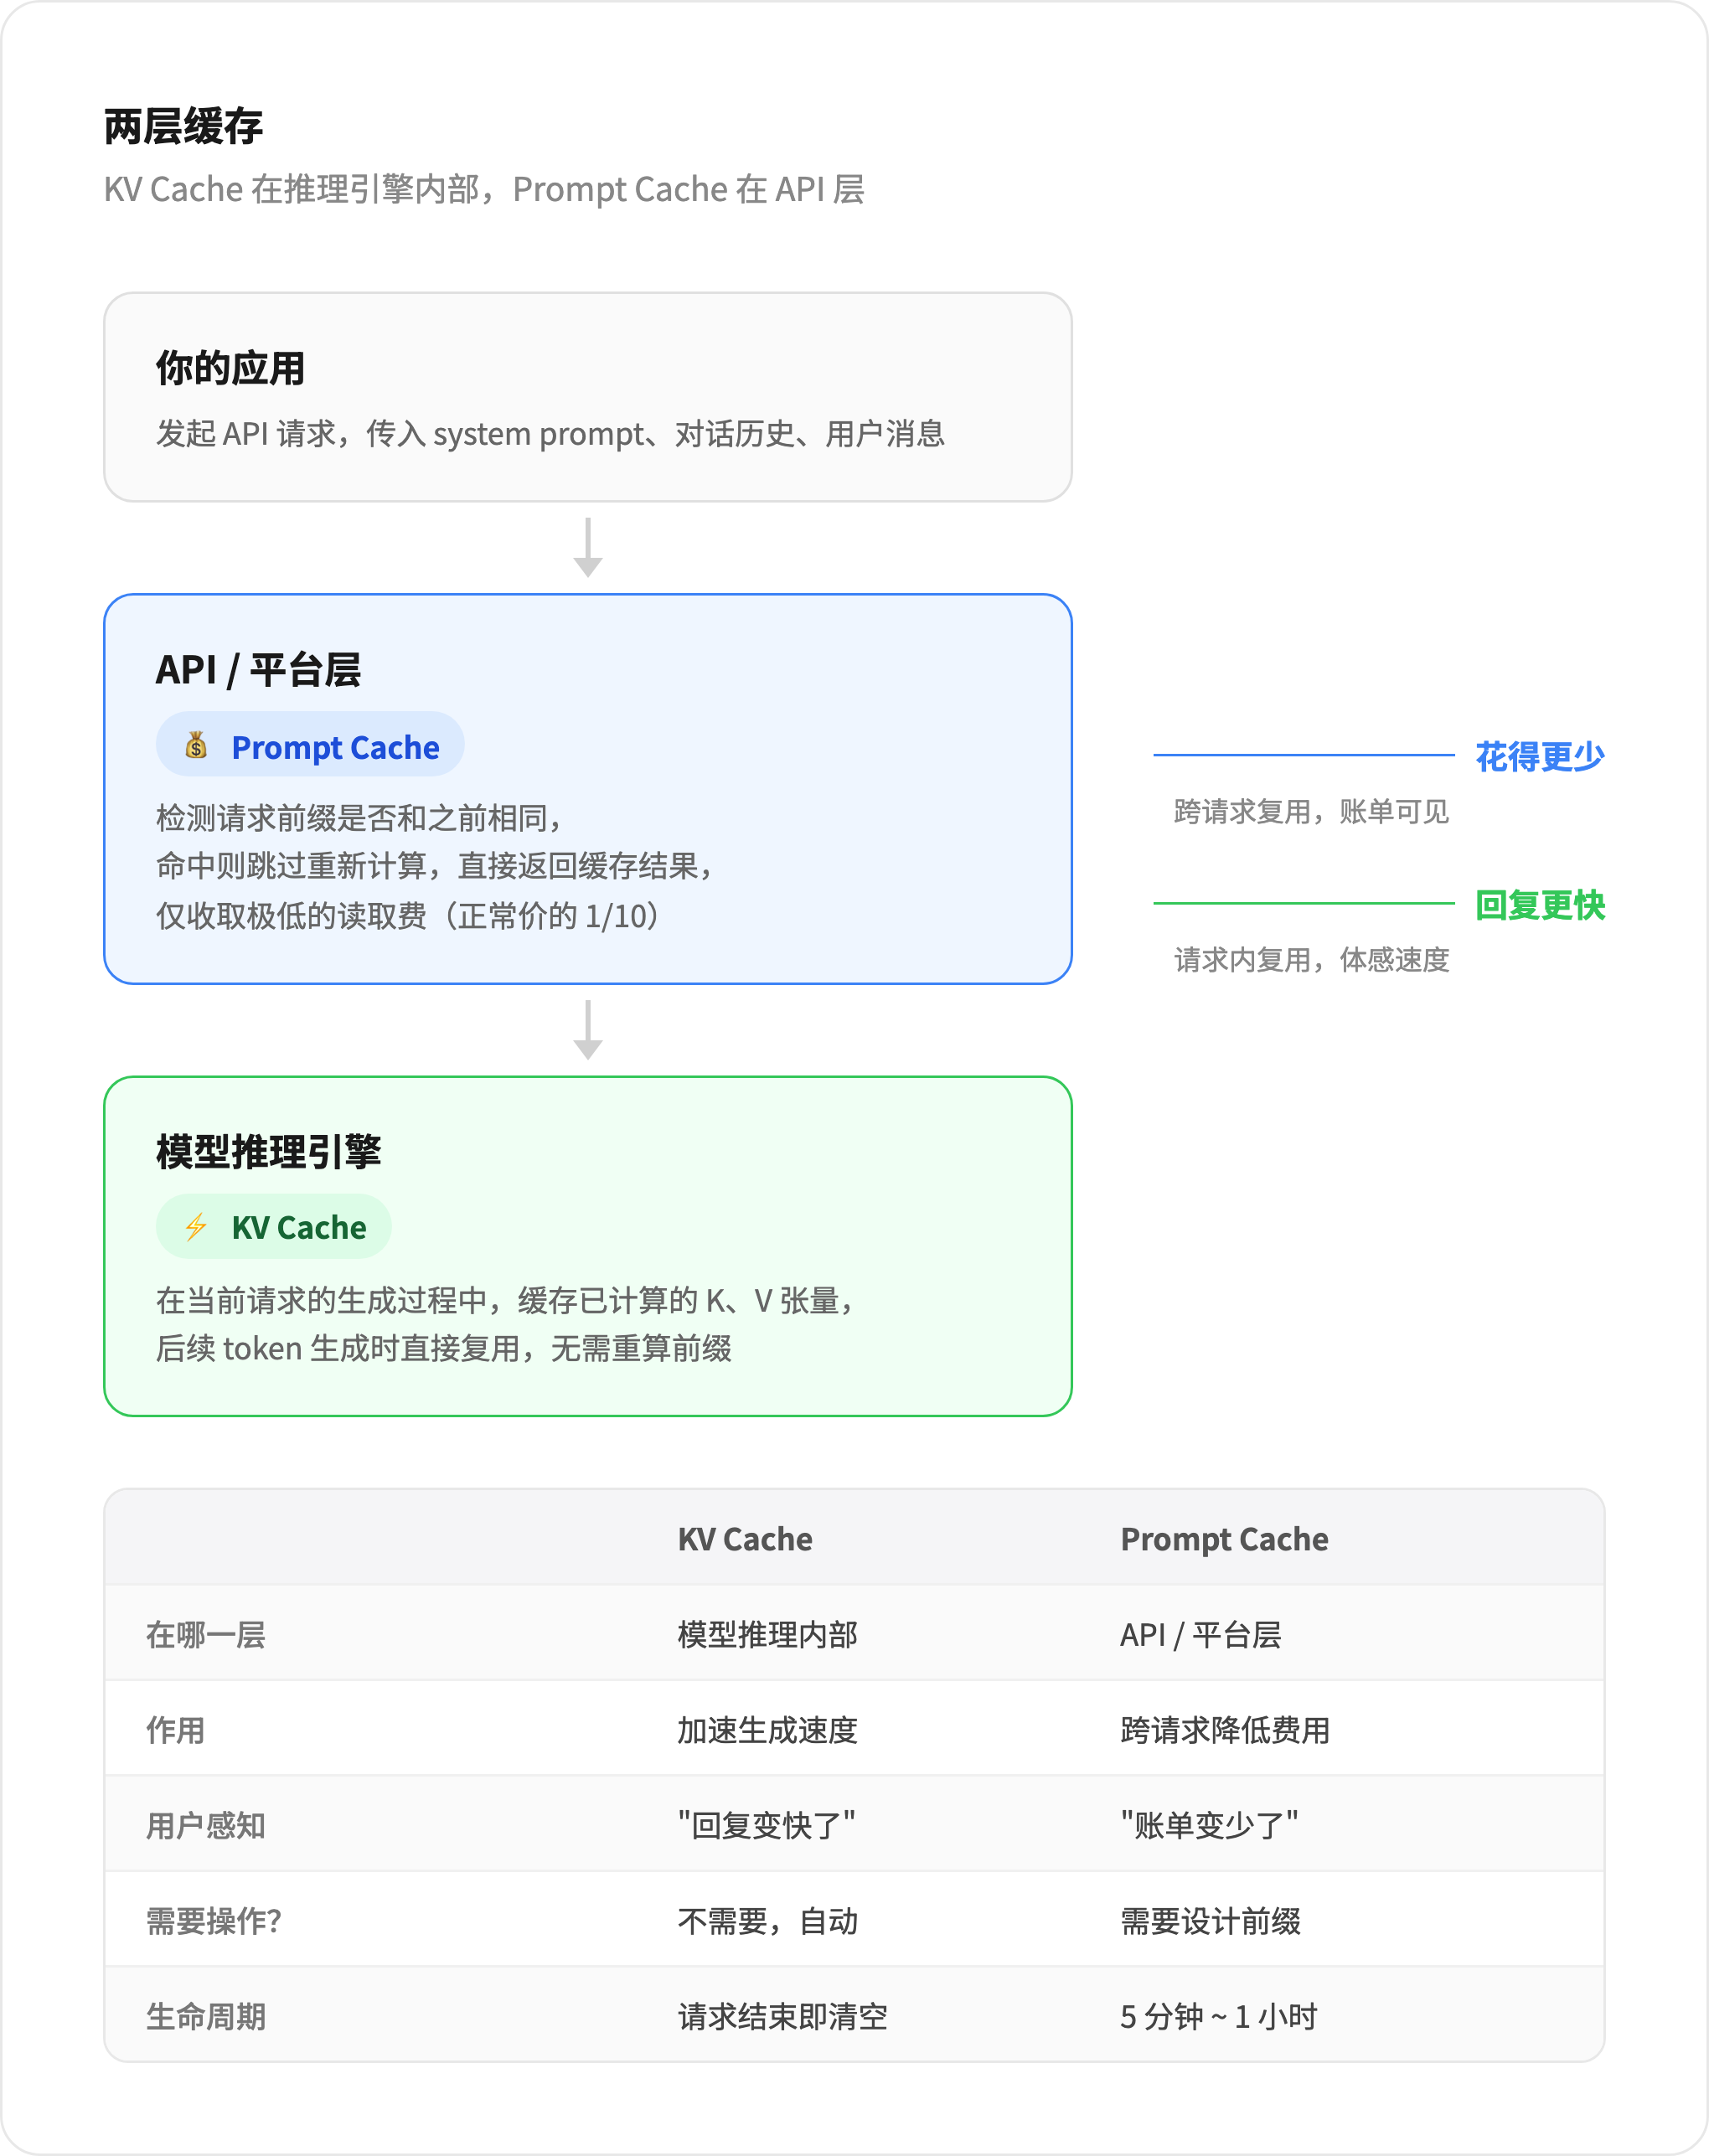
KV Cache 是推理引擎内部的机制,让生成速度更快。还有另一层缓存直接影响账单——Prompt Cache。
4.1 两层缓存,别搞混
| KV Cache | Prompt Cache | |
|---|---|---|
| 在哪一层 | 模型推理内部 | API / 平台层 |
| 作用 | 加速单次请求的逐字生成 | 跨请求复用重复输入,降低费用 |
| 用户感知 | ”回复变快了" | "账单变少了” |
| 需要操作吗 | 不需要,引擎自动管理 | 需要设计(或使用自动缓存) |
| 生命周期 | 请求结束即清空 | 5 分钟 ~ 1 小时 |
KV Cache 让你用得更快,Prompt Cache 让你花得更少。
4.2 Prompt Cache 的核心思路
很多场景里,每次请求都携带一段固定内容:几千字的系统提示、用户上传的长文档、固定的 few-shot 示例。每次都让模型重新处理,慢且按全量计费。Prompt Cache 的做法:
第一次处理后缓存 KV 结果,后续请求前缀相同则直接复用,只收极低的”读取费”。
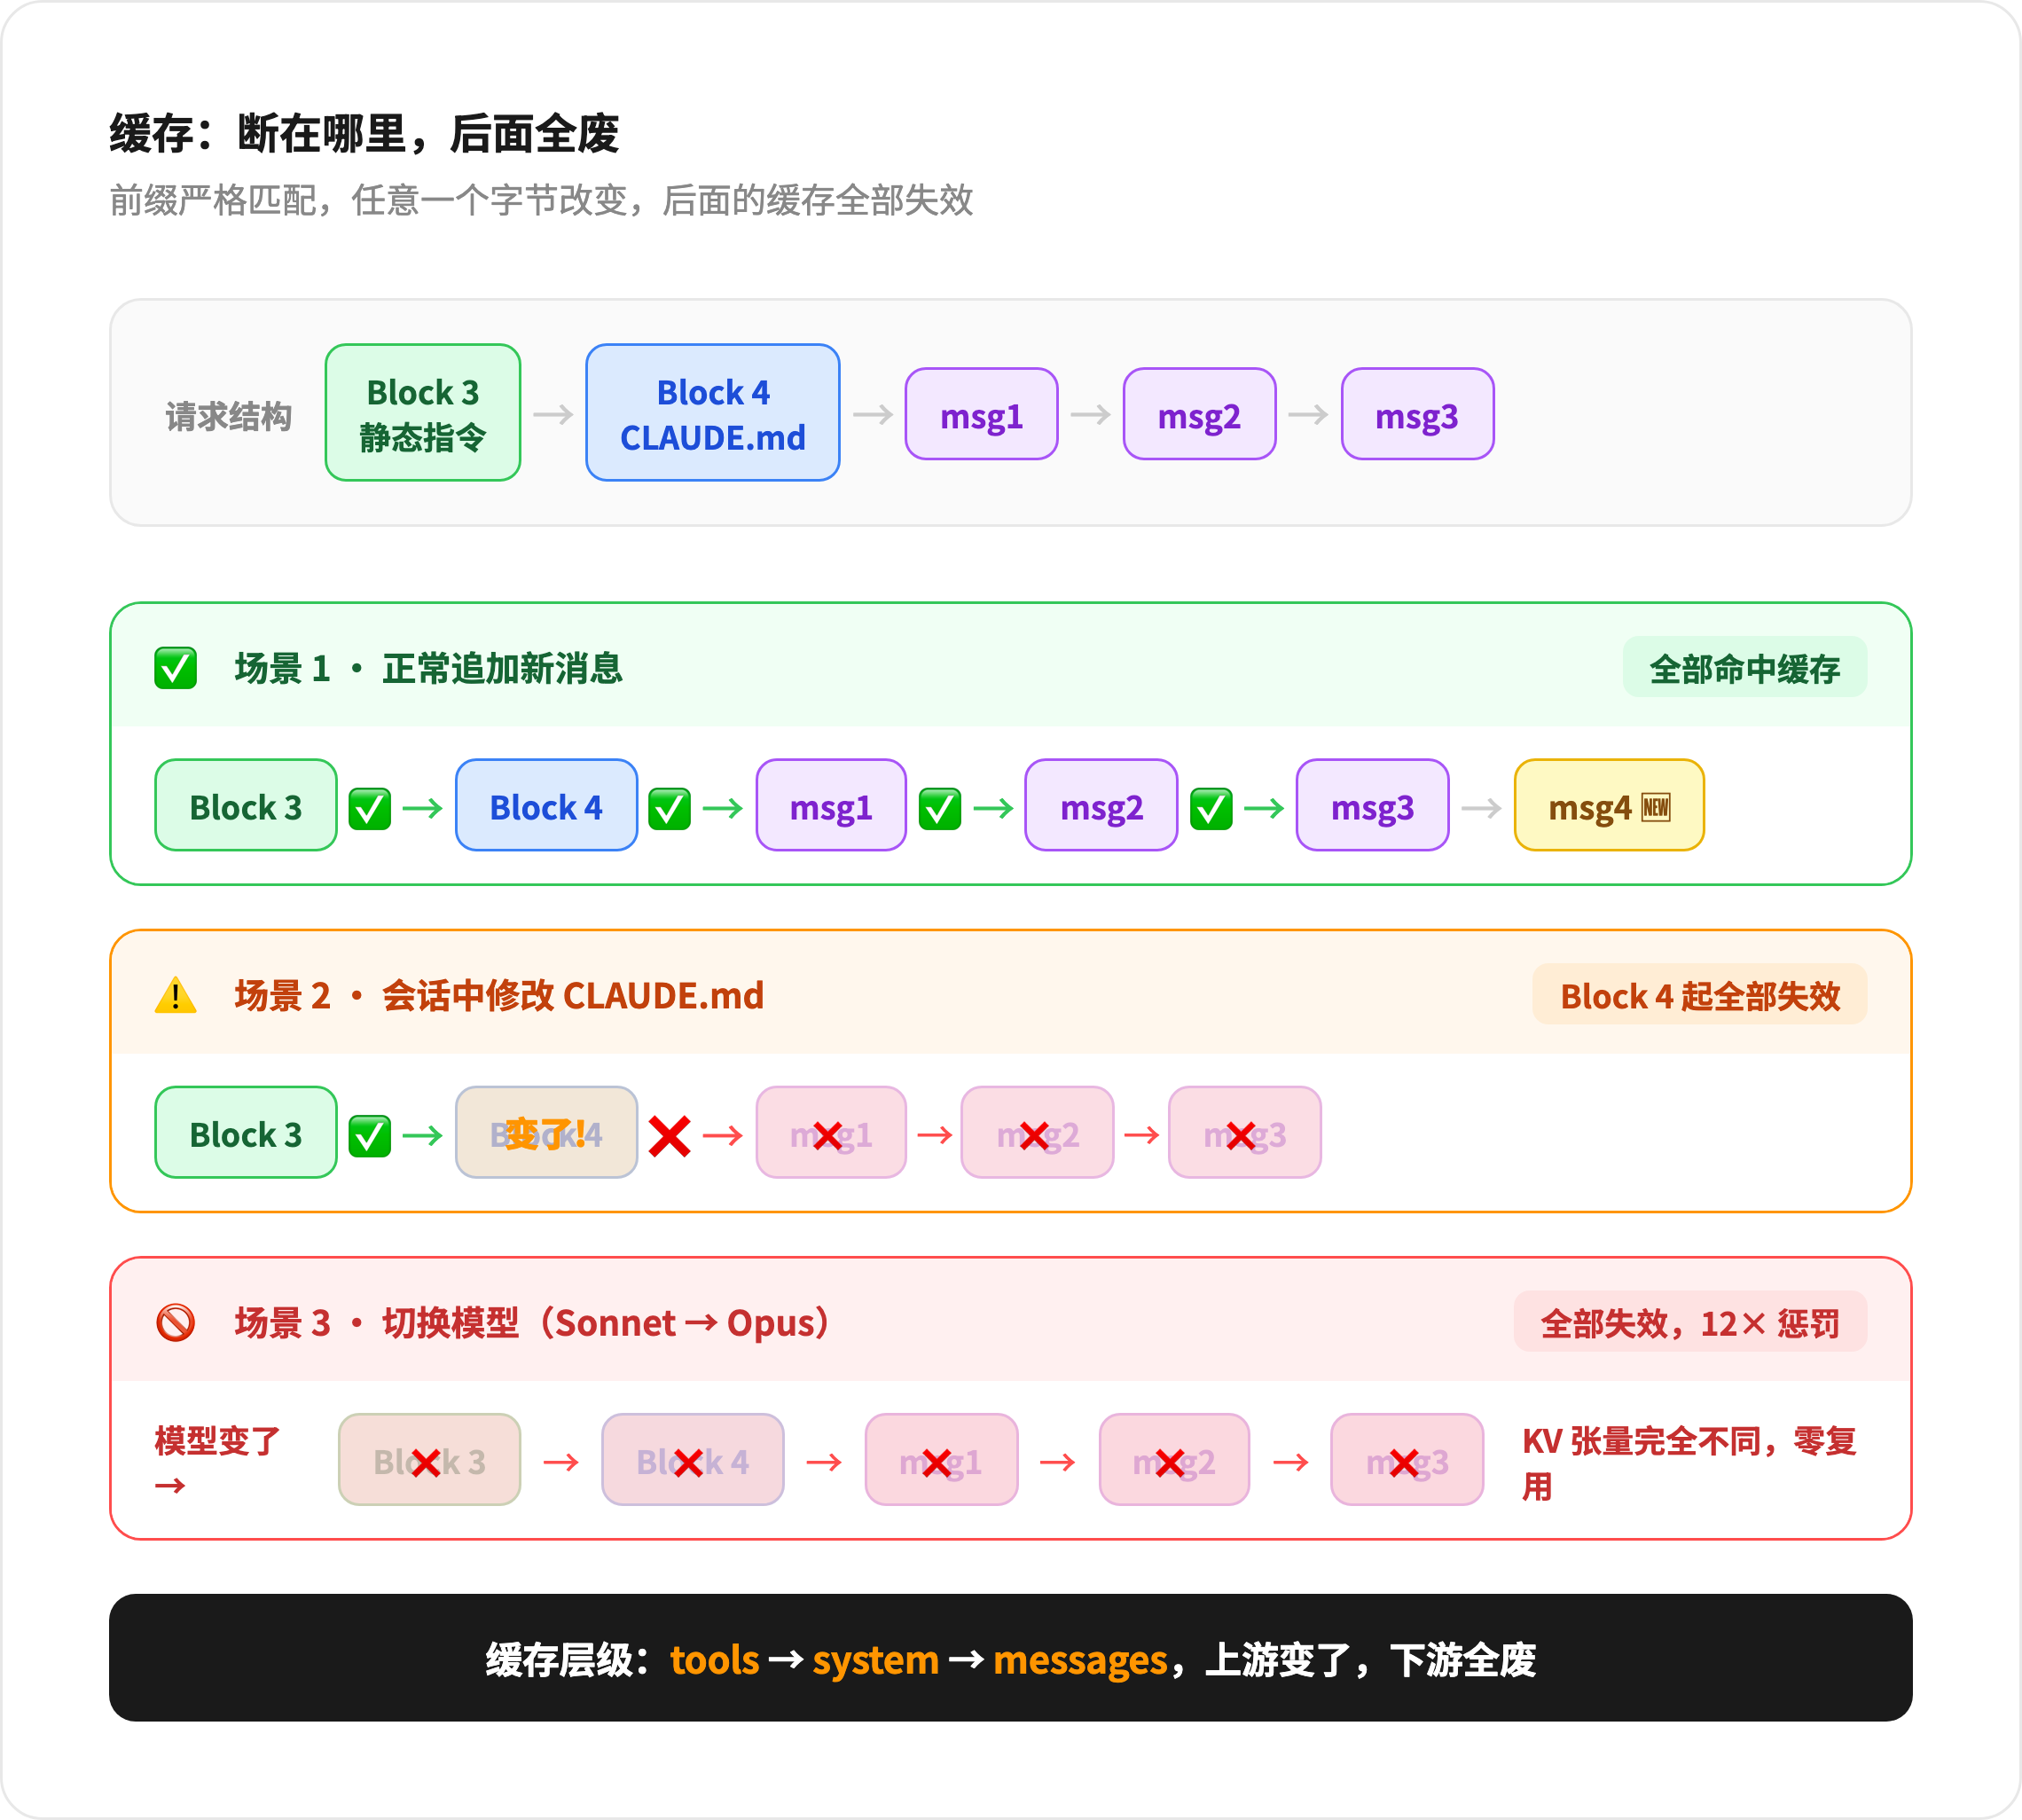
关键是前缀匹配——从第一个 token 开始连续匹配,中间任何一个字节变了,后面的缓存全部失效。
请求 1: [系统提示 A][工具定义][消息1]           → 全部写入缓存
请求 2: [系统提示 A][工具定义][消息1][消息2]     → 前缀命中缓存,只有消息2全价
请求 3: [系统提示 B][工具定义][消息1][消息2]     → 系统提示变了!全部重新计算
                ↑ 这里不同,后面全废
4.3 各平台定价
以 Claude 系列为例(价格单位:美元 / 百万 Token):
| 模型 | 正常输入 | 缓存写入(5min) | 缓存写入(1h) | 缓存命中 | 输出 |
|---|---|---|---|---|---|
| Opus 4.7 | $5 | $6.25 | $10 | $0.50 | $25 |
| Sonnet 4.6 | $3 | $3.75 | $6 | $0.30 | $15 |
| Haiku 4.5 | $1 | $1.25 | $2 | $0.10 | $5 |
规律很简单:缓存写入 = 正常输入 × 1.25(5min)或 × 2(1h);缓存命中 = 正常输入 × 0.1,相当于 90% 折扣。
OpenAI 的策略不同:自动缓存,不需要显式写 cache_control,也不单独收写入费;命中缓存的输入 token 会按 cached input 价格计费。控制权少一些,但省心。
4.4 一个具体的费用计算
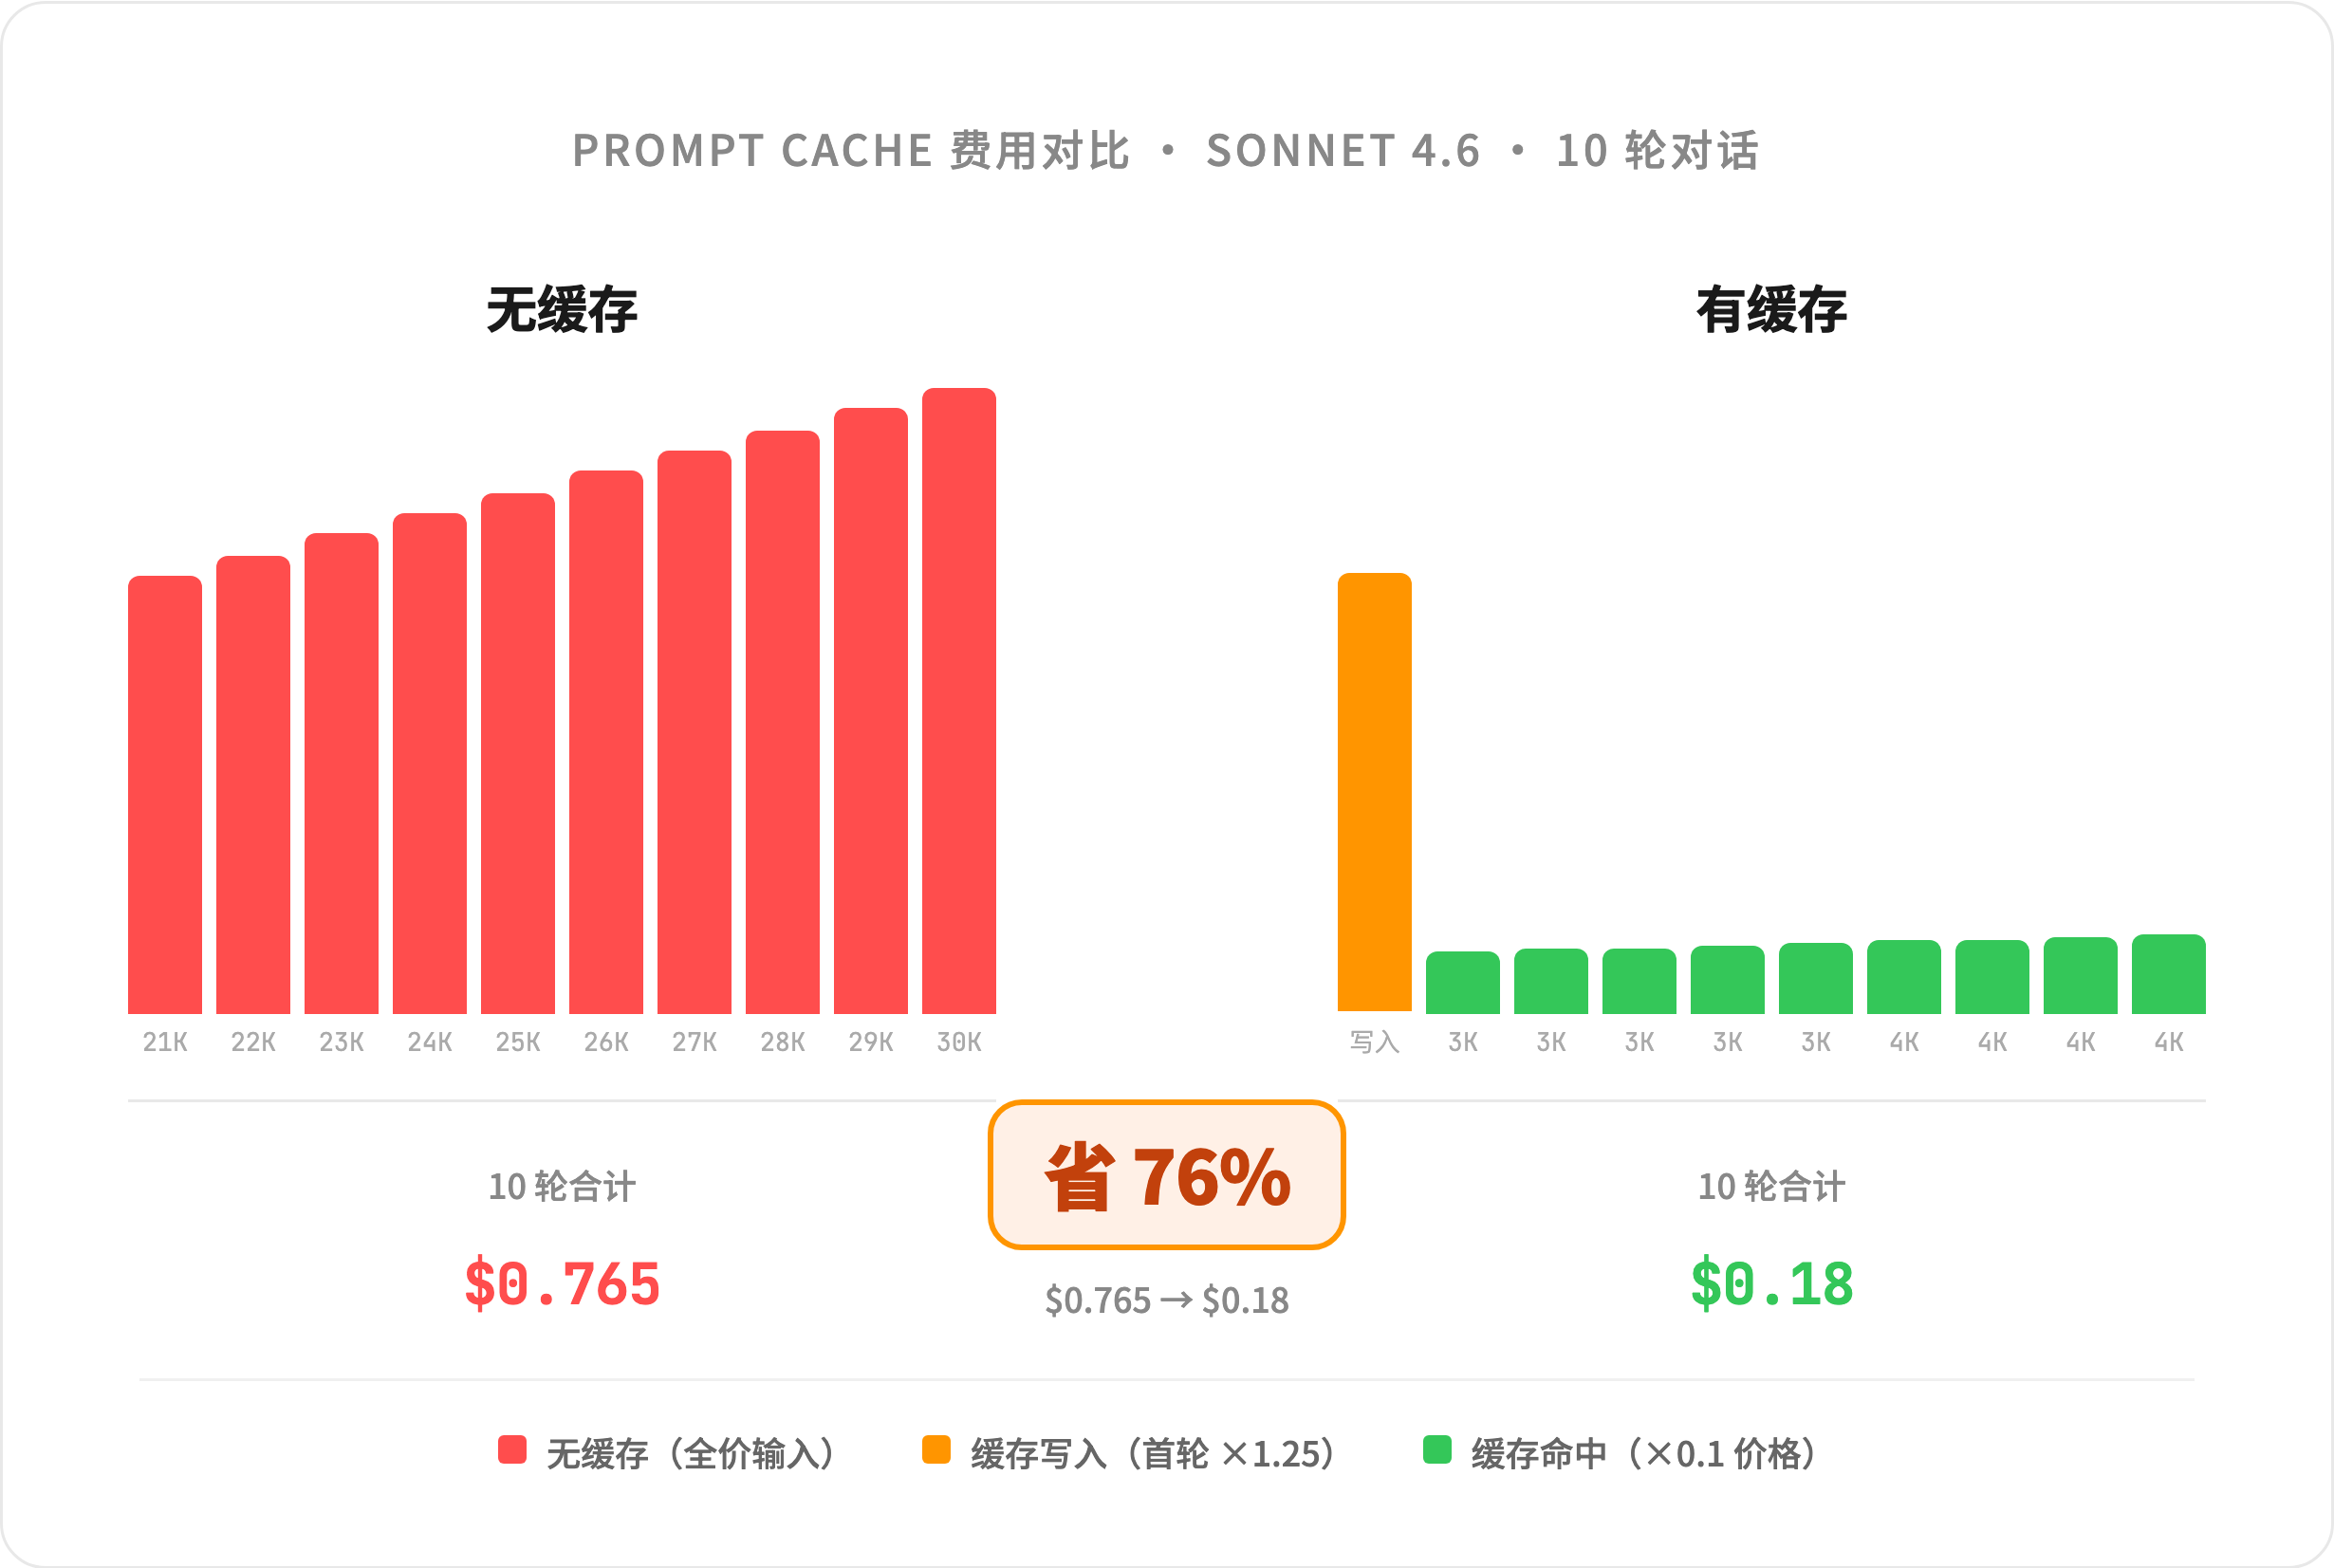
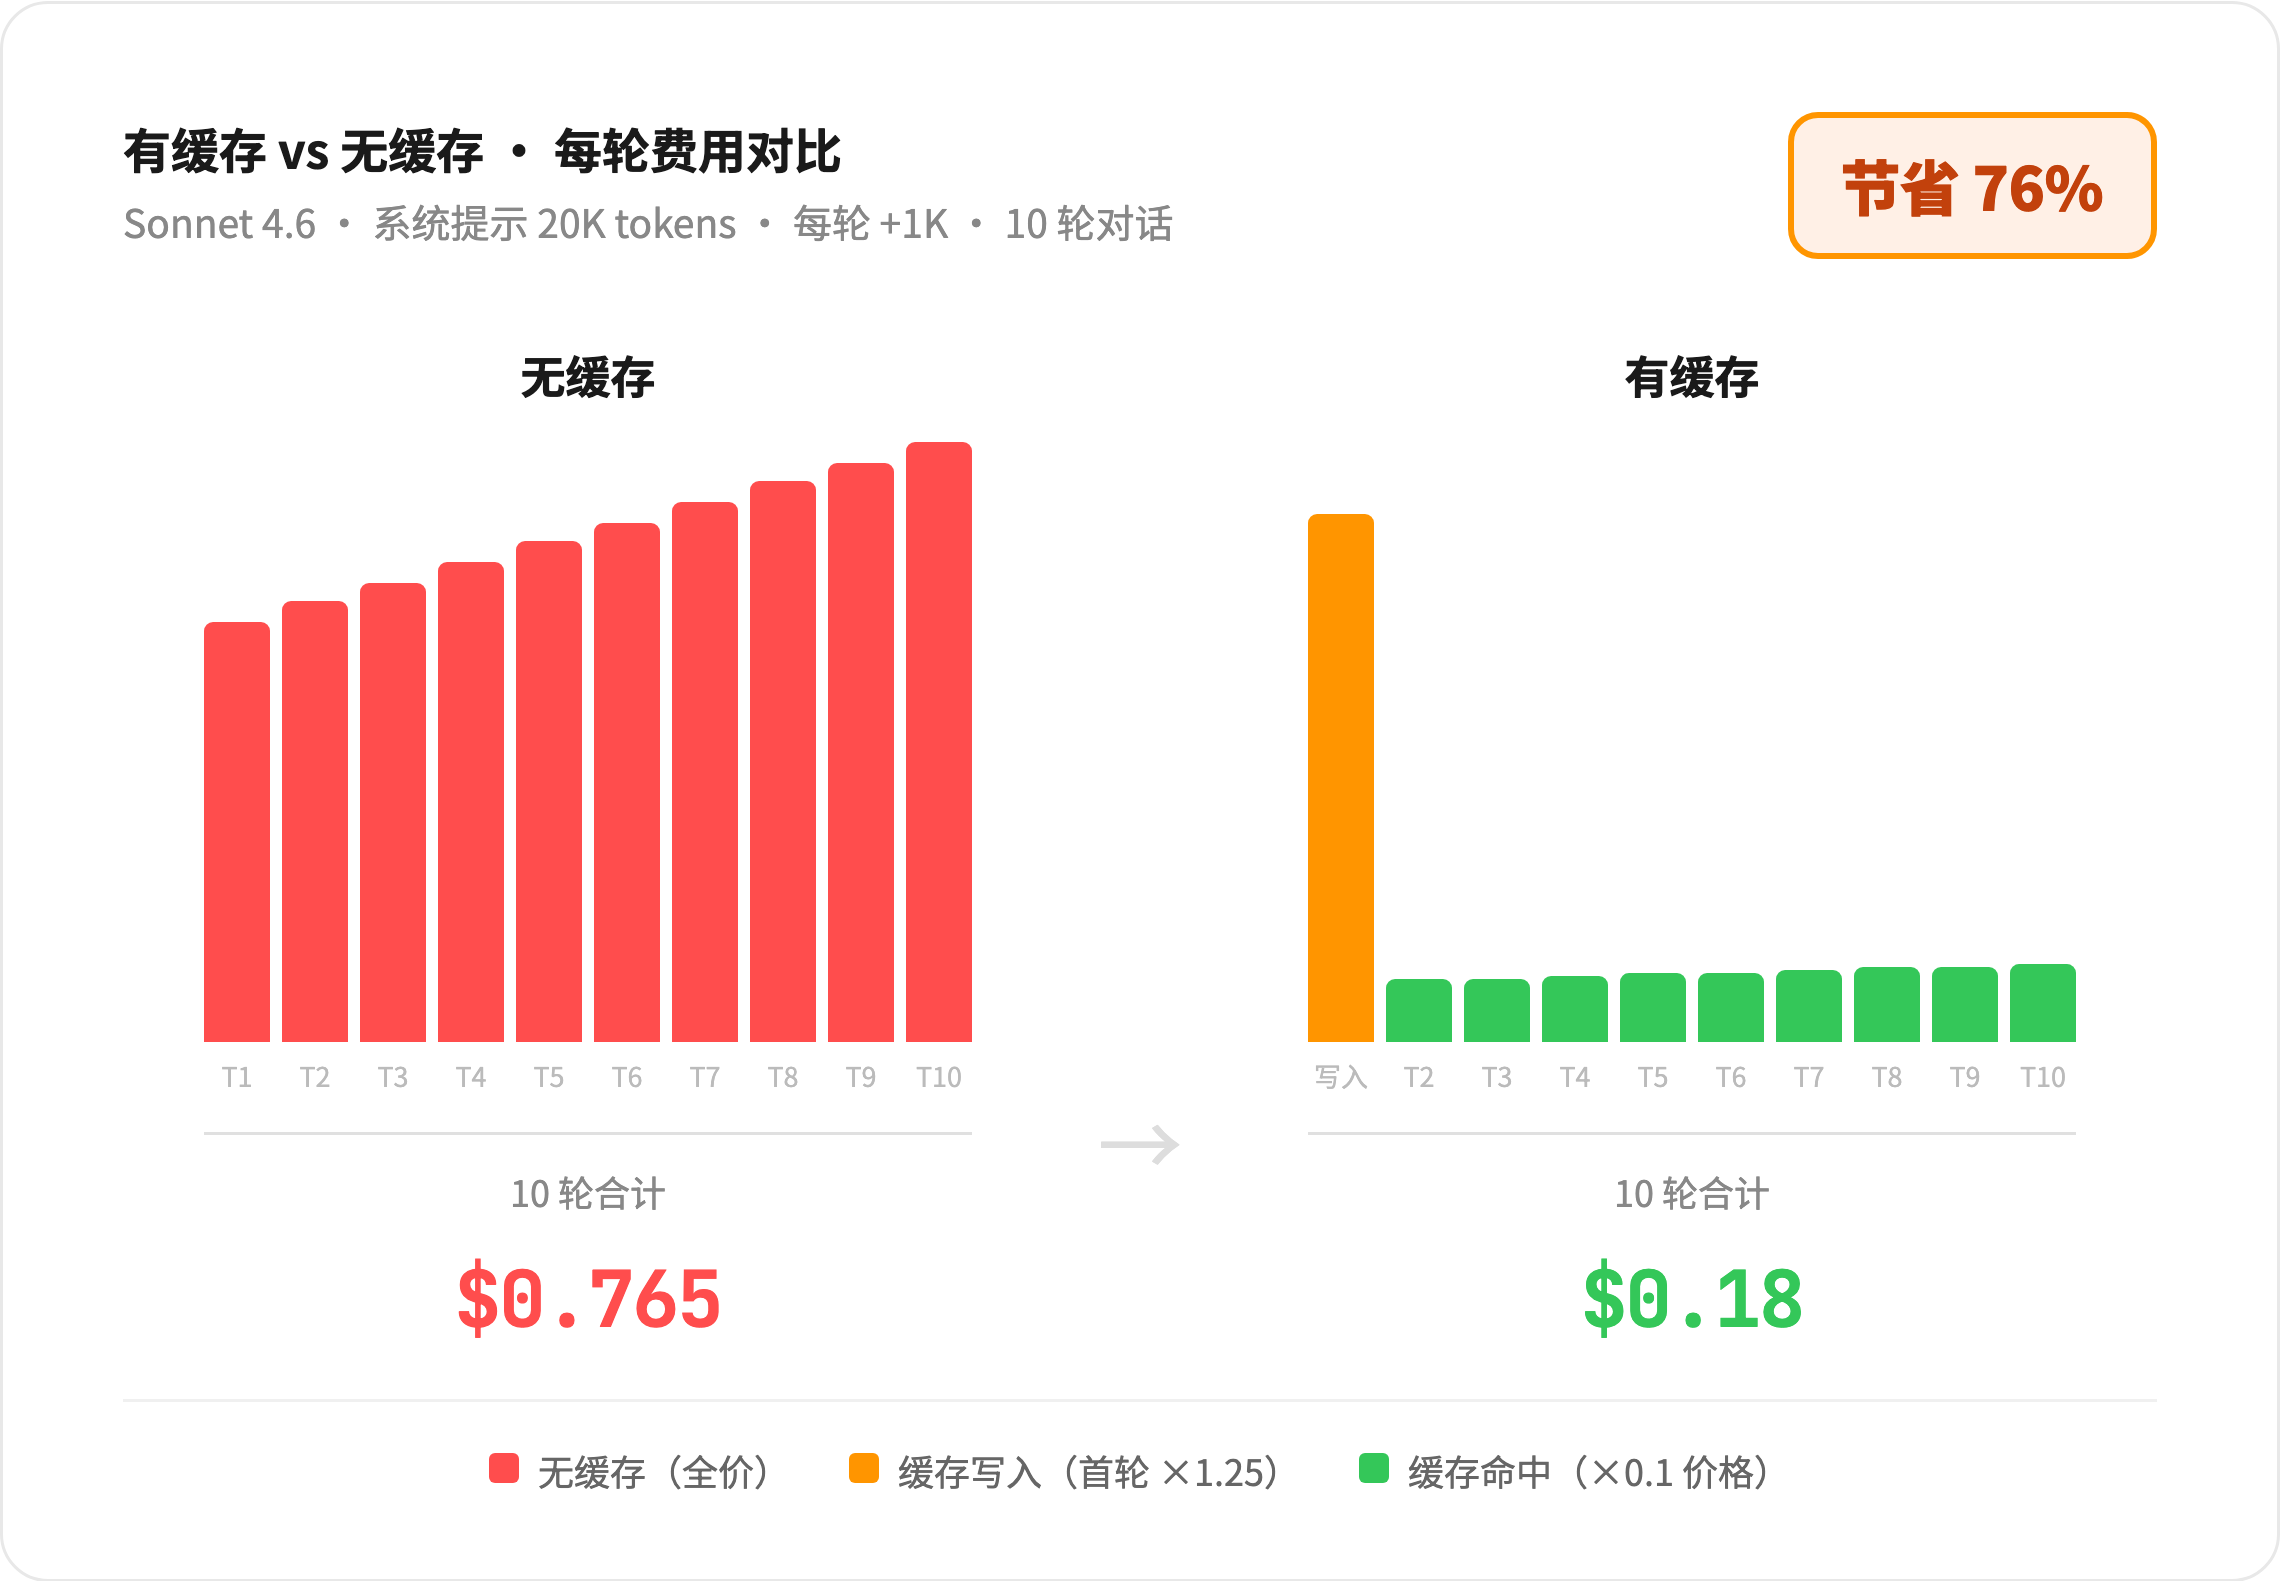
场景:10 轮对话,系统提示 20K tokens,每轮新增 ~1K tokens。使用 Sonnet 4.6。
没有缓存(每轮全价):
  Turn 1:  21K × $3/M = $0.063
  Turn 2:  22K × $3/M = $0.066
  ...
  Turn 10: 30K × $3/M = $0.090
  ────────────────────────────
  10 轮输入总计:255K tokens × $3/M = $0.765
有缓存(前缀命中 1/10 价格):
  Turn 1:  21K × $3.75/M = $0.079    ← 首次写入缓存(贵25%)
  Turn 2:  21K × $0.30/M + 1K × $3/M = $0.0093
  Turn 3:  22K × $0.30/M + 1K × $3/M = $0.0096
  ...
  Turn 10: 29K × $0.30/M + 1K × $3/M = $0.0117
  ────────────────────────────
  10 轮输入总计:≈ $0.18
$0.765 vs $0.18,缓存省了 76%。轮数越多省得越多,20 轮以上的对话节省比例可达 85%+。
4.5 缓存有效期
| 平台 | 默认有效期 | 可扩展至 | 续期机制 |
|---|---|---|---|
| Claude | 5 分钟 | 1 小时(2x 价格) | 每次命中自动续期 |
| OpenAI | 5-10 分钟 | 最长可达 24 小时(不同模型和负载下不保证) | 自动管理 |
缓存在每次被读取时自动续期。持续对话就不会过期,但停下来喝杯咖啡超过 5 分钟,缓存就没了,下一轮要重新付写入费。1 小时 TTL 基本消除这个问题,后面 5.7 节会讲 Claude Code 的两档 TTL。
五、Claude Code 的缓存工程
Claude Code(以下简称 CC)把缓存用到了一个相当极端的程度。Anthropic 团队在复盘文章里提到,Claude Code 的系统设计高度围绕 prompt caching 展开,缓存命中率下降几个百分点都会被当成需要排查的线上问题。
这一章基于官方分享、公开文档和日常使用观察,拆解它的缓存设计。
5.1 每轮对话的真实开销
每发一条消息,CC 都会把以下内容完整打包发给 API:
- 系统指令(角色定义、行为准则)
- ~40 个工具的完整 schema 定义
CLAUDE.md项目上下文- Git 状态快照
- 完整对话历史
- 本轮消息
第 30 条消息的实际输入量 = 前 29 条的全部内容 + 新消息。没有缓存,这个成本会失控。
5.2 Prompt 的多层结构
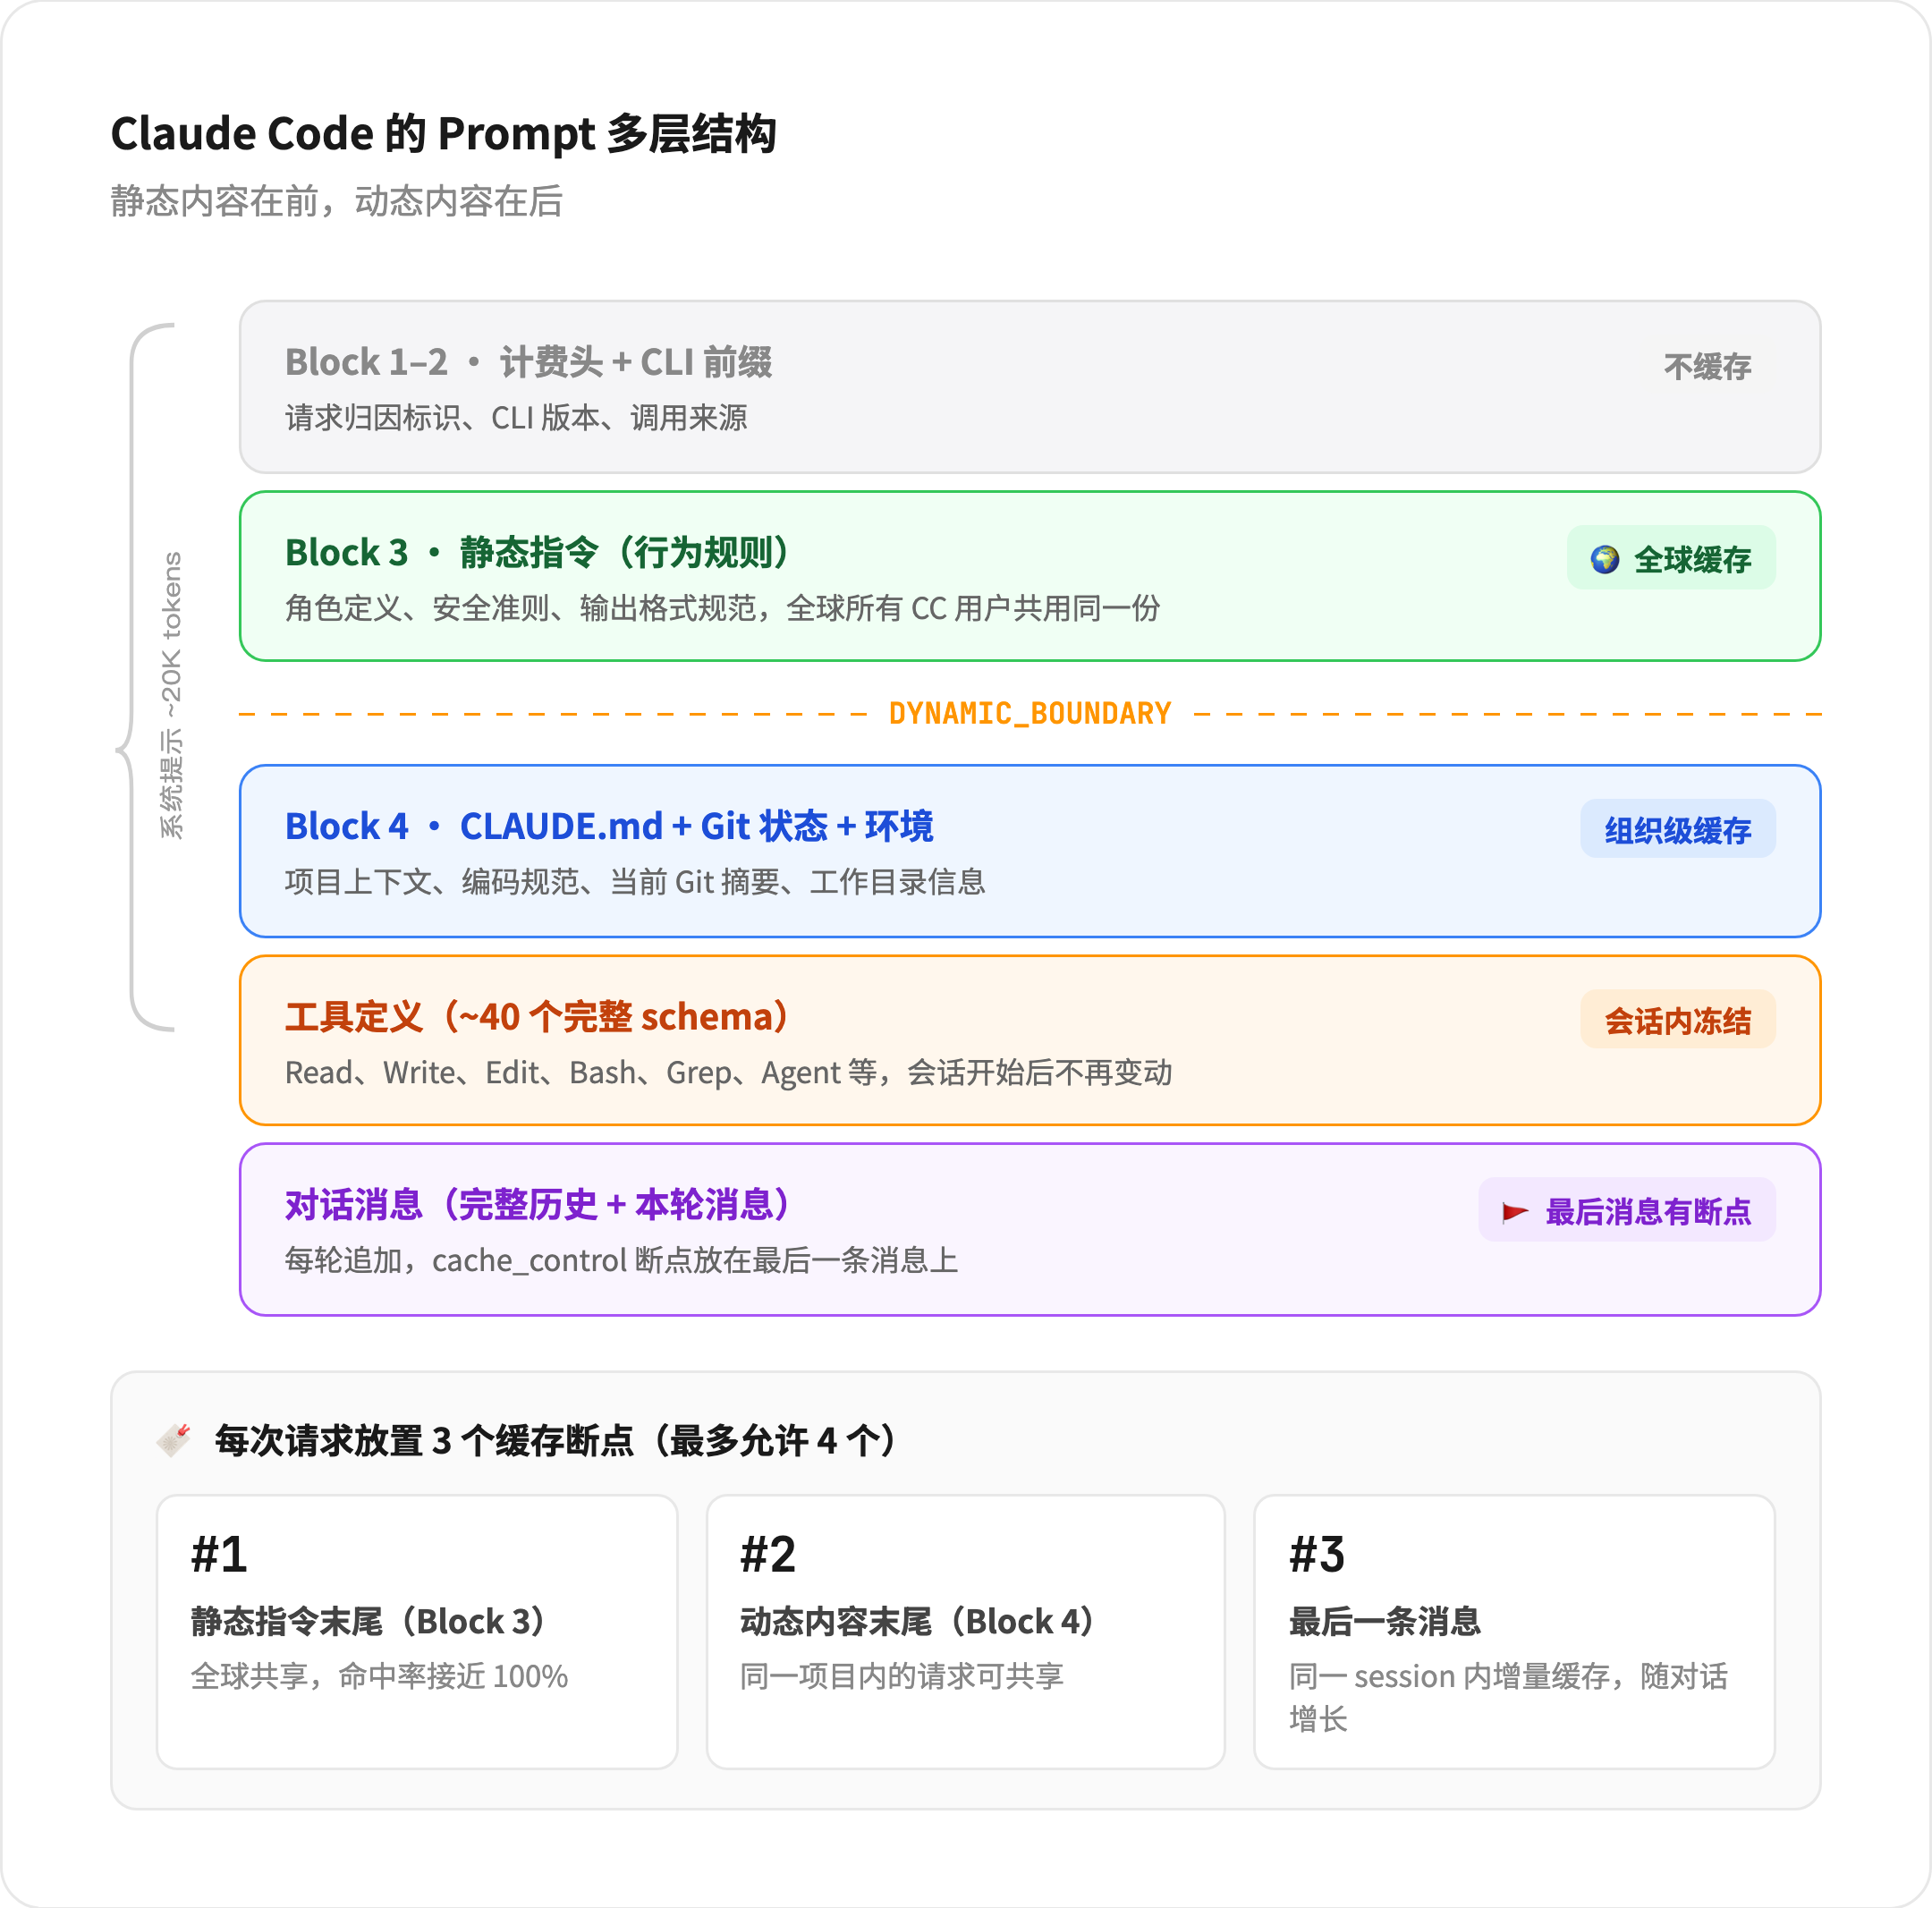
CC 发出的 prompt 不是一整块,而是专门为缓存优化过的多层结构:
┌──────────────────────────────────────────────────────────┐
│ system(系统提示词,~20K tokens)                           │
│                                                          │
│   Block 1-2: 计费归因头 + CLI 前缀  → 不缓存                │
│   Block 3:   静态指令(行为规则等)   → 跨 session 复用      │
│   ──── DYNAMIC_BOUNDARY ────                             │
│   Block 4:   动态内容(CLAUDE.md 等) → 项目级复用           │
├──────────────────────────────────────────────────────────┤
│ tools(工具 schema,session 内冻结)                        │
├──────────────────────────────────────────────────────────┤
│ messages(对话历史 + 本轮消息)                             │
│   最后一条消息上放 cache_control 标记                       │
└──────────────────────────────────────────────────────────┘
静态内容在前,动态内容在后——最大化前缀匹配的长度。
Block 3 是所有 CC 请求共用的同一段静态内容,理论上命中率最高。注意:Anthropic 的缓存按组织隔离,不同组织之间不会共享缓存;同一组织内的不同 session,只要前缀相同,就有机会命中同一份缓存。
5.3 三个缓存断点
每个请求精确放置 3 个缓存断点(Anthropic 最多允许 4 个):
| 断点 | 位置 | 作用 |
|---|---|---|
| #1 | 静态指令末尾(Block 3) | 跨 session 复用,命中率最高 |
| #2 | 动态内容末尾(Block 4) | 同一项目内复用 |
| #3 | 最后一条消息 | 同一 session 内增量缓存 |
工具定义没有单独的断点,但通常不需要单独处理——Anthropic 的工具定义本来就在 prompt 结构的靠前位置,只要后续断点命中,工具定义也会一起受益。
历史消息也不需要每条都打断点。更关键的是控制旧消息和大型工具输出的体积,避免让每轮请求都背着越来越长的历史。
5.4 围绕缓存的设计哲学
CC 团队有几个”反直觉但为了缓存不得不这样做”的设计决策:
Plan Mode:不切换工具集,用工具来切换模式
直觉做法是进入 plan mode 时,把工具集换成只读工具(只保留 Read、Grep 等)。但这会改变工具定义,缓存前缀变了,整个缓存失效。
CC 的做法:始终保留全部工具,新增 EnterPlanMode 和 ExitPlanMode 作为工具。进入 plan mode 时,在消息里告诉模型”你现在只探索不执行”。工具定义永远不变,缓存永远不断。顺带一提,因为 EnterPlanMode 是工具,模型可以自主决定进入 plan mode,不需要用户手动触发。
Tool Search:不删除工具,用 stub 替代
CC 可以加载几十个 MCP 工具,全部放进请求太贵,但删除工具会破坏缓存。解决方案是延迟加载:不直接改变前缀里的完整工具集合,而是先给模型轻量入口,模型需要时再按需加载完整定义。
用消息更新信息,不改系统提示
时间变了、文件被修改了?直觉是更新系统提示,但这会破坏缓存。CC 在下一条用户消息或工具结果里加一个 <system-reminder> 标签,把更新信息放在消息流里。前缀不变,缓存不断。
5.5 Compaction 的缓存安全设计
/compact 把整个对话历史压缩成摘要,以摘要重新开始对话。但压缩本身需要一次 API 调用——如果这次调用用了不同的 system prompt 和工具集,就无法复用主对话的缓存,等于白白多付一次全价。
CC 的做法:Cache-Safe Forking
压缩请求使用完全相同的 system prompt、工具定义、历史消息,只在末尾追加压缩指令。从 API 视角看,这个请求和主对话上一个请求几乎一模一样,缓存前缀被完整复用。
主对话最后一个请求:
  [system] [tools] [msg1] [msg2] ... [msg30] [user: "帮我重构这个函数"]

压缩请求:
  [system] [tools] [msg1] [msg2] ... [msg30] [user: "帮我重构这个函数"]

  [assistant: "上一轮回答 / 工具结果"] [user: "请压缩以上对话为摘要"]
  ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
  这整段前缀和主对话完全一致,缓存命中!只有最后的压缩指令是新的。
压缩时 CC 还会自动:
- 去除工具输出里的图片和大型冗余内容
- 用当前模型生成精炼摘要
- 自动重新注入最近读过的 5 个文件(防止”失忆”)
- 保留 Plan 和激活的 Skills 上下文
完成一个子任务或历史明显变长后再 /compact,不要在上下文还很短时过早压缩。可以附加指令:/compact 保留 API 设计决策和文件修改记录。
5.6 缓存断裂检测
CC 监控每次调用的 cache_read_input_tokens。如果比上次下降 >5% 且绝对值 >2000 tokens,判定为缓存断裂,自动分析原因:系统提示变了?工具增减了?TTL 过期了?模型切换了?
5.7 两档 TTL (Time To Live)
| 用户类型 | 缓存有效期 | 条件 |
|---|---|---|
| 所有用户 | 5 分钟 | 默认 |
| API 显式设置 extended cache | 1 小时 | 需要在缓存断点上设置更长 TTL,写入价格更高 |
5 分钟 TTL 下,停下来喝杯咖啡再回来,缓存可能已经失效,系统提示要重新付写入费。1 小时 TTL 基本消除这个问题,但代价是缓存写入更贵,适合长任务或中间会频繁中断的工作流。
如果通过第三方中转使用 API,还要确认对方是否完整透传 cache_control 和使用量字段,否则账单里看不到真实的缓存命中情况。
5.8 子智能体
CC 在处理复杂任务时会启动子智能体:
Explore Agent(代码库探索):搜索文件和代码时自动启动,用 Haiku 而不是主对话的 Sonnet 或 Opus。按当前定价,Haiku 比 Sonnet 便宜约 2/3,比 Opus 便宜约 80%,同时跳过 CLAUDE.md 加载,省掉数千 token。注意:sub-agent 的工具集和消息历史都和主线程独立,不共享主线程缓存,每次启动等于一次”迷你冷启动”。
描述越模糊,Explore Agent 跑的轮数越多,给精确路径比让它猜便宜得多:
- 模糊:“帮我找处理登录的文件” → 多轮搜索
- 精确:“读 src/services/auth.ts” → 直接读取
Plan Agent(架构设计):复杂任务中也可能出现独立规划上下文。它的好处是让主线程更干净,代价是这类上下文通常不能直接复用主线程的完整消息缓存。
六、缓存杀手:哪些操作在悄悄烧钱
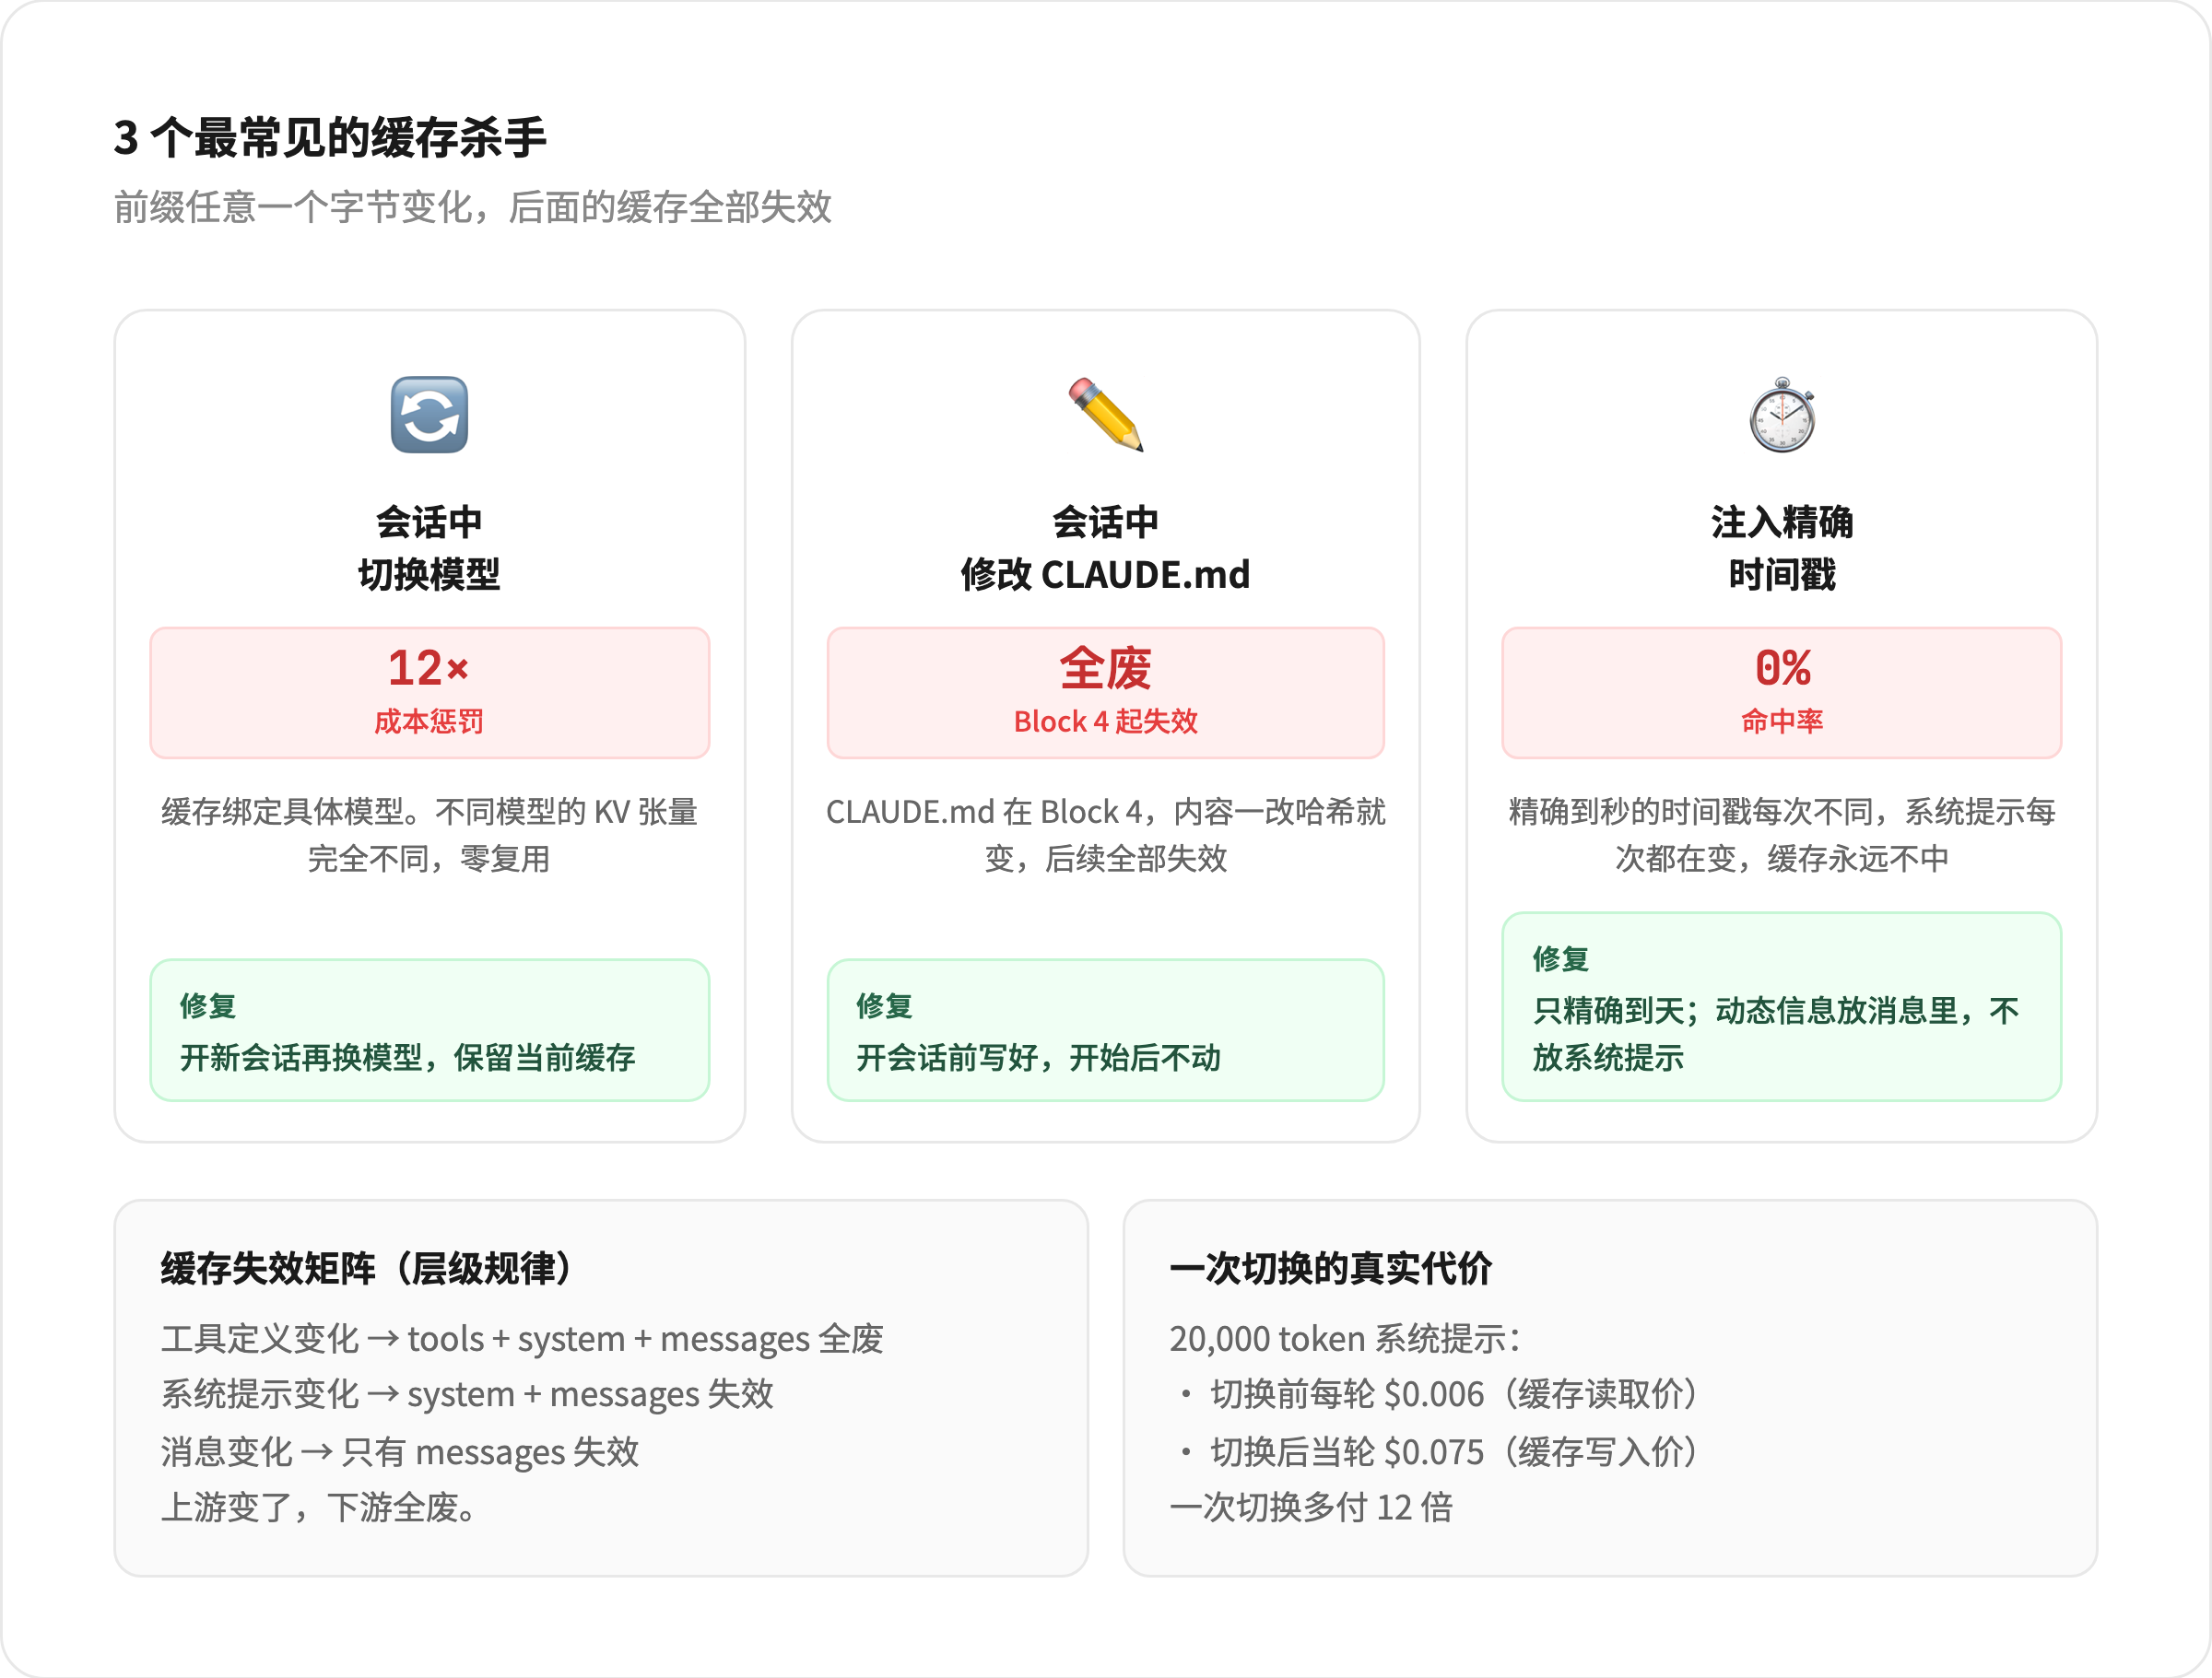
缓存基于严格的前缀匹配。前缀任意一个字节变化,后面的缓存全部失效。以下是最常见的 3 个杀手。
杀手 1:会话中切换模型
缓存绑定具体模型。不同模型的 KV 张量完全不同,零复用。一个 20,000 token 的系统提示:切模型前每轮 $0.006(缓存读取),切模型后当轮 $0.075(缓存写入),一次切换多付 12 倍。
需要换模型,开新会话,别在当前会话里切。
杀手 2:会话中修改 CLAUDE.md
CLAUDE.md 在系统提示的 Block 4 里。内容一改,哈希就变了,Block 4 之后的所有缓存立即失效。开会话前写好,开始后不动。
杀手 3:注入精确时间戳
CC 在系统提示里注入当前日期,但只精确到天。如果精确到秒,每次请求的系统提示都不同,缓存永远不中。通过 API 集成时,不要把每秒变化的内容塞进系统提示——把动态信息放在消息里(参见 5.4 节)。
缓存失效矩阵(按 Anthropic 官方文档整理)
| 什么变了 | 工具缓存 | 系统提示缓存 | 消息缓存 |
|---|---|---|---|
| 工具定义 | ❌ | ❌ | ❌ |
| 开关 Web Search | ✅ | ❌ | ❌ |
| 开关 Citations | ✅ | ❌ | ❌ |
| 切换 Fast Mode | ✅ | ❌ | ❌ |
| tool_choice 参数 | ✅ | ✅ | ❌ |
| 添加/删除图片 | ✅ | ✅ | ❌ |
| Thinking 参数变化 | ✅ | ✅ | ❌ |
规律:缓存层级是 tools → system → messages,上游变了,下游全废。
七、最佳实践:怎么省钱
核心原则:别碰前缀
保护缓存的(🟢 绿灯):
| 操作 | 为什么安全 |
|---|---|
| 连续对话 | 前缀不变,增量缓存 |
| 复用同一个 session | 共享缓存 |
定期整理 CLAUDE.md | 好习惯,但在会话间隙做 |
破坏缓存的(🔴 红灯):
| 操作 | 代价 |
|---|---|
| 开新 session | 冷缓存,~20K tokens 全价重算 |
改 CLAUDE.md | Block 4 起全部失效 |
| 加减 MCP 工具 | 工具 schema 变化 = 缓存断裂 |
| 切换模型 | 完全失效,12 倍惩罚 |
| 过早 /compact | 消息历史变了 = 部分断裂,等历史明显变长或子任务完成后再用 |
| 发呆超过 TTL | 缓存过期,下轮重新写入 |
架构层策略(节省 50–80%)
1. 一个会话一个任务
话题切换后,旧对话历史变成每轮都要付费的噪音。新任务开新会话。
2. 主动 /compact,但别太早
完成子任务或历史明显变长时压缩,附上保留指令:/compact 保留 API 设计决策和文件修改记录。太早压缩会损失消息缓存,太晚压缩会让历史持续膨胀。
3. 固定模型,不中途切换
需要换模型就开新会话,当前所有缓存保留。
4. 开会话前写好 CLAUDE.md
会话中改 CLAUDE.md 等于主动让系统提示缓存失效。用 /init 初始化好再开始。
提示词层策略(节省 20–50%)
1. 一次说完比追问省 token
三条消息 = 三次完整上下文加载,一条消息 = 一次。
✅ "总结这个文件,列出要点,建议标题"
❌ "总结这个文件" → "列出要点" → "起个标题"
2. 编辑原始消息,不要发新消息纠正
每条新消息永久追加进历史,后续每轮都要为它付费。CC 支持直接编辑历史消息(两次 Esc 回滚)。
3. 给精确路径,不让 AI 搜索
模糊描述触发 Explore Agent 多轮搜索,精确路径直接读取。
4. 在 CLAUDE.md 里排除大型生成文件
JSON 文件的 token 密度是普通代码的 2 倍(2 字节 ≈ 1 token vs 4 字节 ≈ 1 token)。package-lock.json 动辄数万 token,一旦被读入上下文就是巨大浪费。CC 默认已排除 package-lock.json、yarn.lock 等,自定义的大型生成文件需要手动排除。
5. 分段工作
把大任务拆成几个独立会话,每段各自压缩,比一条龙跑到底更可控。
总结
省 Token 的本质是让操作习惯对齐缓存架构。
- 保持前缀稳定:固定模型、固定
CLAUDE.md、动态内容放消息不放系统提示 - 用好缓存杠杆:把常用上下文写入
CLAUDE.md,10× 折扣从第二轮起生效 - 控制历史增长:一任务一会话,主动 /compact,批量提问
同样的调用量,理解缓存机制的人比不理解的人,API 费用差 3~5 倍。