一、背景
Andrej Karpathy 发布了 autoresearch 项目:让 AI agent 自主设计实验、跑实验、分析结果、决定下一步,形成自动化的研究闭环。
在 上一篇文章 中,我在一个 toy project 上验证了这个思路的可行性,也踩了不少坑——agent 会覆盖实验记录、会修改评测标准来”作弊”。那次经历的结论是两句话:autoresearch 确实有效,但裸跑迟早翻车。
这次我把它搬到自己的真实项目上:生理信号(PPG)预训练,用对比学习训练一个通用 encoder。数据量千万级,训练一次要几个小时。串行迭代一天最多验证十来个 idea——要让 autoresearch 真正发挥作用,必须并行。
二、方案
2.1 一个大脑,六条手臂
硬件是 6 块 A800-80G。并行的基础是 git worktree:每块 GPU 对应一个 worktree、一组独立的代码和配置。怎么组织这 6 路研发,有三种思路:
- 多 agent 独立跑:每个 worktree 一个独立 session。简单,但信息不共享,idea 容易撞车,token 开销翻倍。
- Agent teams 协作:多个 agent 互相通讯同步进展。理论最优,但协调协议本身就是个工程问题,对超参搜索大材小用。
- 单 agent 中央调度:一个 Claude agent 管所有 worktree——分配任务、汇总结果、决定下一步。
我选了第三种。实现最简单,信息最集中,不会重复探索。
2.2 Wave 机制
实验以 wave(波次)为单位推进,每波五步:
- 中央 agent 给 6 条 branch 各分配一个实验任务
- 6 路并发训练(每条 branch 固定一块 GPU)
- 全部跑完后汇总结果,逐个判定 keep 或 discard
- keep 的保留 commit,discard 的用 git reset 回退
- 根据本波结果规划下一波
2.3 约束规则
上次 toy project 的教训是 agent 会钻空子,所以这次把规则提前写进 prompt:
判定规则:每个实验必须同时通过三道 gate 才算 keep——表示不坍缩、valid loss 不反弹、改进幅度超过噪声阈值。表示是否坍缩用 SER 衡量:它反映 representation 的质量,模型坍缩成常数解时 SER 会塌向 0,所以 gate 要求守住一条下限。
Scope 锁定:数据加载、划分比例、训练 epoch 数全部锁死,agent 只能在模型和超参层面做文章。
撞车检查:每波 launch 前 diff 6 条分支的配置,任何两条完全相同就必须改其一。
三、实验结果
30 波 × 6 路 = 180 条实验记录(baseline 是同一次训练在 6 条分支各记一份,实际独立训练约 175 次),历时约 4 天。
| 指标 | Baseline | Leader | 变化 |
|---|---|---|---|
| min_valid_loss | 6.3062 | 6.1195 | -3.0% |
| final_valid_loss | 6.5699(epoch 3 后反弹) | 6.1195(5 epoch 单调下降) | -0.45 |
| final_SER | 75.30 | 106.08(更健康) | +30 |
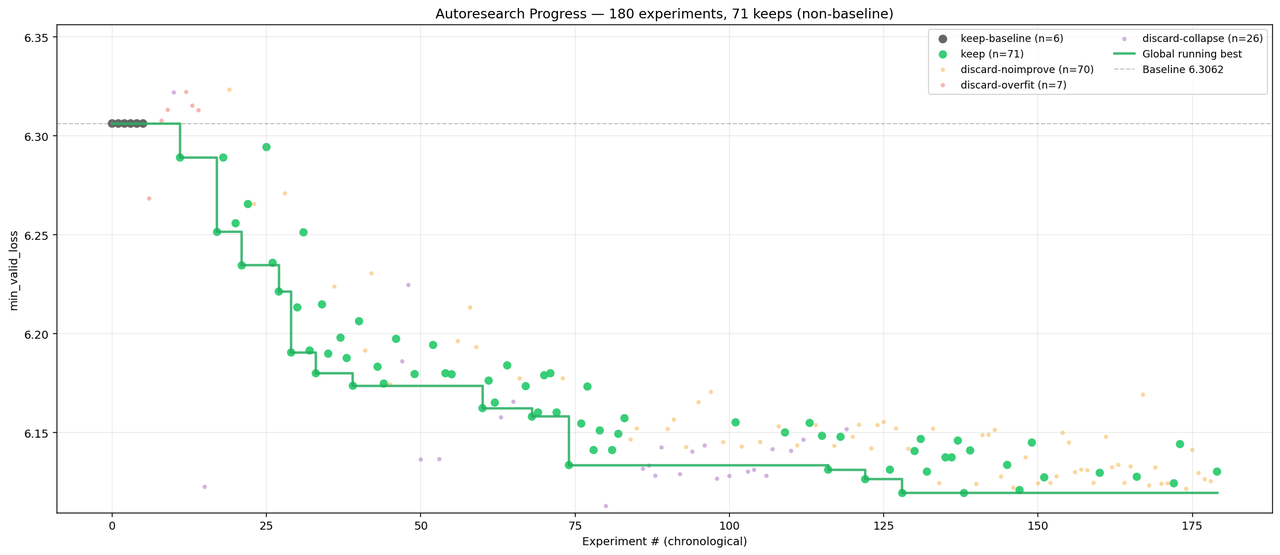
上图是 180 条记录按时间顺序排列的 min_valid_loss 散点,绿色阶梯线是全局 running best。前 25 次实验下降最快(6.31 → 6.19),来自最早的两次突破;此后边际收益递减,约第 75 次之后 running best 进入 6.13-6.12 区间,后面 100 次实验只再贡献了约 0.01——这就是 plateau。
值得一提的是,中途出现过几次 loss 看似更低、但 SER 坍缩的”假突破”,全部被三道 gate 拦了下来——事前设计的约束规则确实在关键时刻起了作用。
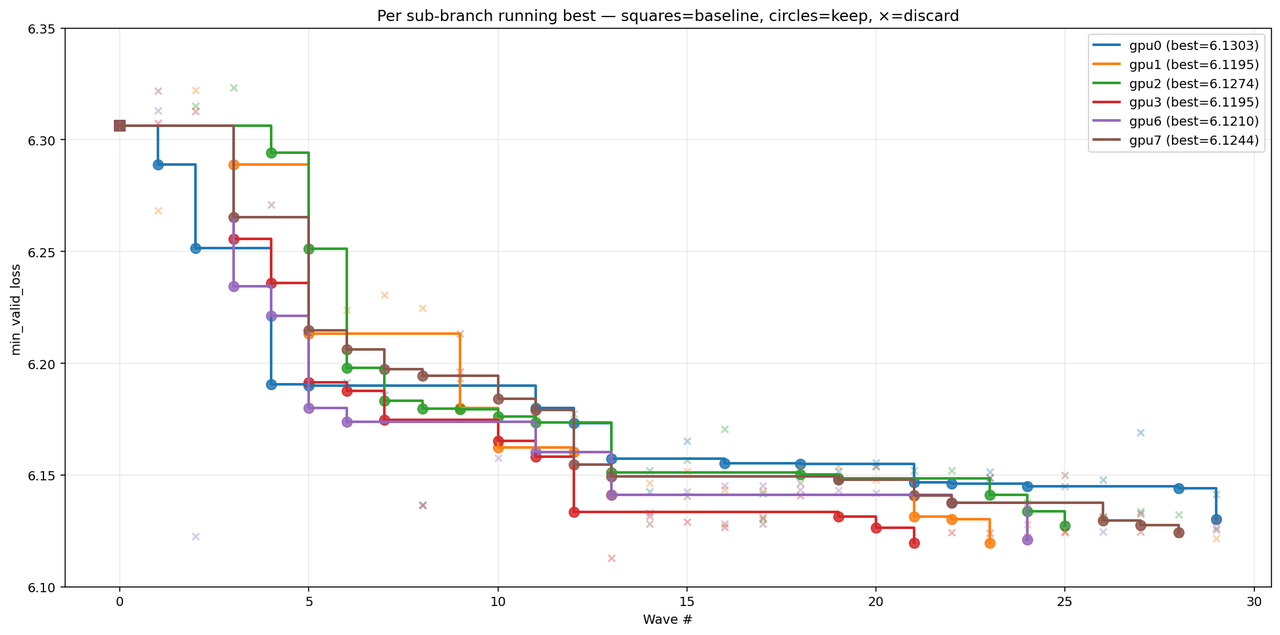
上图是 6 条分支各自的 running best 随 wave 推进的变化。它们从差异明显的起点出发,最终全部收敛到 6.12-6.13 的狭窄区间;其中 gpu1 和 gpu3 沿完全不同的路径到达了同一个最优配置。多条独立路径指向同一区域,说明结果不是某条分支碰巧撞上的局部最优——这是可信度的强信号。
有效改动的规律
从 6.31 到 6.12 的下降,最终归结为 6 个超参层面的改动。具体是哪 6 个不重要,重要的是它们呈现的规律:改动之间有严格的依赖顺序,第一个改动是整条链的地基,没有它后面的都叠不上去;而且每个改动的甜点区间都极窄,稍微偏离就会坍缩或停滞——这意味着 agent 需要大量试错才能找到这些窄窗口。
另一侧同样清楚:模型结构类改动几乎全军覆没。原因是训练预算只有 5 个 epoch,新结构来不及充分训练,而 baseline 结构本身是论文精心调过的。教训:训练预算紧张时,第一轮全押超参,结构改动留到预算宽松后。
四、方法论沉淀
4.1 核心模式:Isolate → Propagate → Stack
三次主要突破都遵循同一个三步模式:
Isolate:某条 branch 做单因子改动,意外突破天花板。关键是只改一个变量,其他不动。
Propagate:下一波把这个改动扩散到所有 6 条 branch,验证它是普遍有效还是局部效应。三次突破的扩散成功率都在 75% 以上。
Stack:只有经过 propagate 验证的因子,才有资格与其他有效因子组合。
跳过 propagate 直接 stack,是大部分失败 wave 的共同原因:两个单独有效的改动,叠在一起可能互相干扰。
4.2 搜索空间的正确切片
6 路并行不等于 6 份贪心副本。有效做法是 6 条 branch 各自沿不同 axis 探索,本地贪心,跨 branch 比较。实操中两条 branch 走到同一配置的事发生了 3-4 次,每次浪费一整路算力——所以 commit 前必须 diff config,确认至少有一个字段不同。
4.3 交互陷阱
参数之间存在隐蔽的交互效应,每个都花了 2-3 波才识别。最典型的一个参数:早期调它直接导致坍缩,被判 discard,一度形成”这个参数不能动”的错误直觉;直到另一个改动就位后再试,同样的值反而成了最终 leader 的一部分。
这类陷阱的共同特点是:单独看每个改动都合理,组合起来才互相干扰。应对只有纪律——一波一因子,不同时动两个可能耦合的参数。
4.4 何时该放弃
连续 2 波 6 条 branch 全部 discard,是 plateau 的信号,应该切换探索方向;换了方向仍然全军覆没,才是真正的 plateau。我们的 leader 在最后 9 波未被突破,多个正交方向的尝试全部无效——这是可靠的停止信号。
五、踩坑与教训
1. CPU 数据加载瓶颈。 6 路同时训练,瓶颈不在 GPU 而在 CPU 端的数据读取和预处理,单次训练明显变慢。没有专门解决,放在空闲时段跑,影响可控。
2. Idea 撞车。 Agent 上下文窗口有限,历史太长会遗忘做过什么,偶尔重复实验。撞车检查缓解了这个问题,但没有根除。
3. 过拟合验证集。 Agent 反复根据验证集指标决策,本质上是在验证集上做搜索,轮次越多越容易过拟合。需要额外留一个独立测试集做最终评估。
4. 缓存缺失。 部分实验可以复用之前的中间结果,但当前流程没有缓存机制,每次从头训练,浪费算力。
5. 环境漂移。 某个 worktree 的运行环境被意外重建,导致首次运行超时。多个 worktree 必须共享同一套环境。
六、关于创新的思考
180 条记录里,103 次被 discard;71 次 keep 中,大多数是对已验证改动的复制和组合,真正把天花板打破的突破只有 3 次。而这 3 次都不是精心设计出来的——是某条 branch 的单因子改动,碰巧越过了一个极窄的窗口。
这让我重新理解创新:它不是规划出来的,而是在大量探索中涌现的。它需要两个前提——足够多的尝试,和对失败的容忍。
但容忍失败有一个前提:失败必须可控。这正是约束规则的角色——三道 gate 拦住”假突破”,scope 锁定防止 agent 改规则作弊,git reset 让每次失败都能干净回退。允许 103 次失败而系统不崩,靠的不是运气,是这套护栏。